セクション1 · レッスン1/全6回
AIGCとは?AIが画像や動画を生成する仕組み
AIGC(AI生成コンテンツ)とは、すでにあるものを認識するだけでなく、画像・動画・音楽・文章など新しいものを生み出すAIのことです。画像モデルはまず「概念の図書館」でアイデアを探し、ランダムなノイズを少しずつ取り除いて、プロンプトに合った画像を浮かび上がらせます。動画モデルは同じことを時間の方向にも行うので、最初のフレームから最後のフレームまで、映像全体が一貫したものになります。
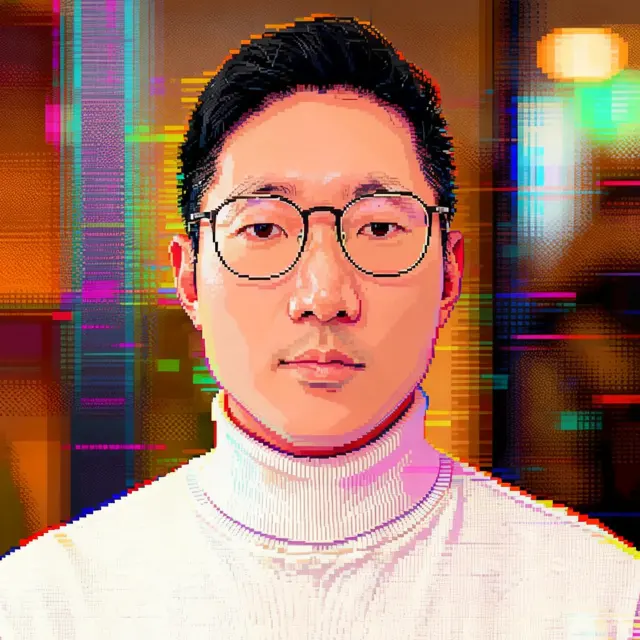
AIGCと従来のAIの違い:料理評論家とシェフ
従来のAIは、すでにあるものを認識します。料理評論家のようなもので、料理を見せると「これはパスタ、これはハンバーガー、これはケーキ」と教えてくれます。顔でスマホのロックを解除するのも同じ仕組みです。
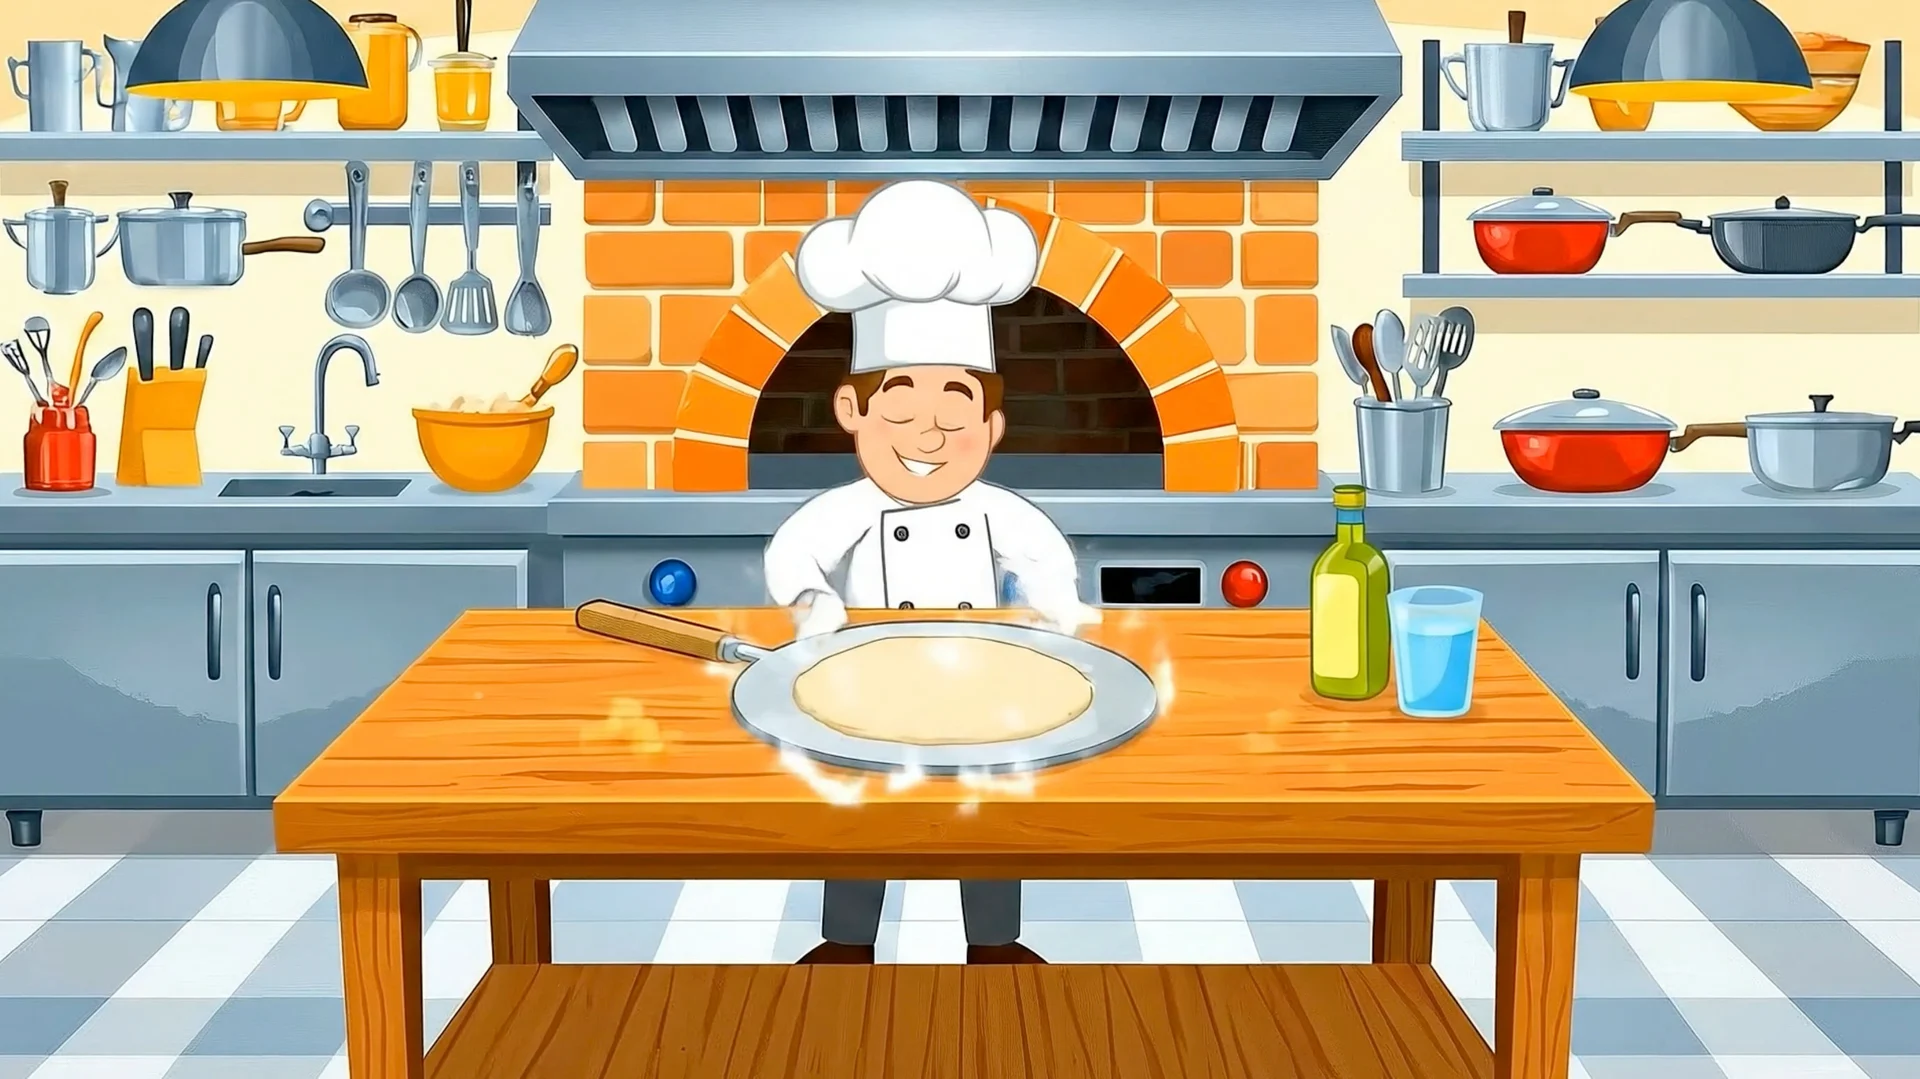
AIGCはシェフのようなものです。料理を見せる代わりに、「パイナップルとチーズ増量の辛いピザ」のように注文をします。すると、冷蔵庫の冷凍ピザを出すのではなく、ゼロから新しい料理を作ってくれます。同じように、これまで存在しなかった顔を描くこともできます。
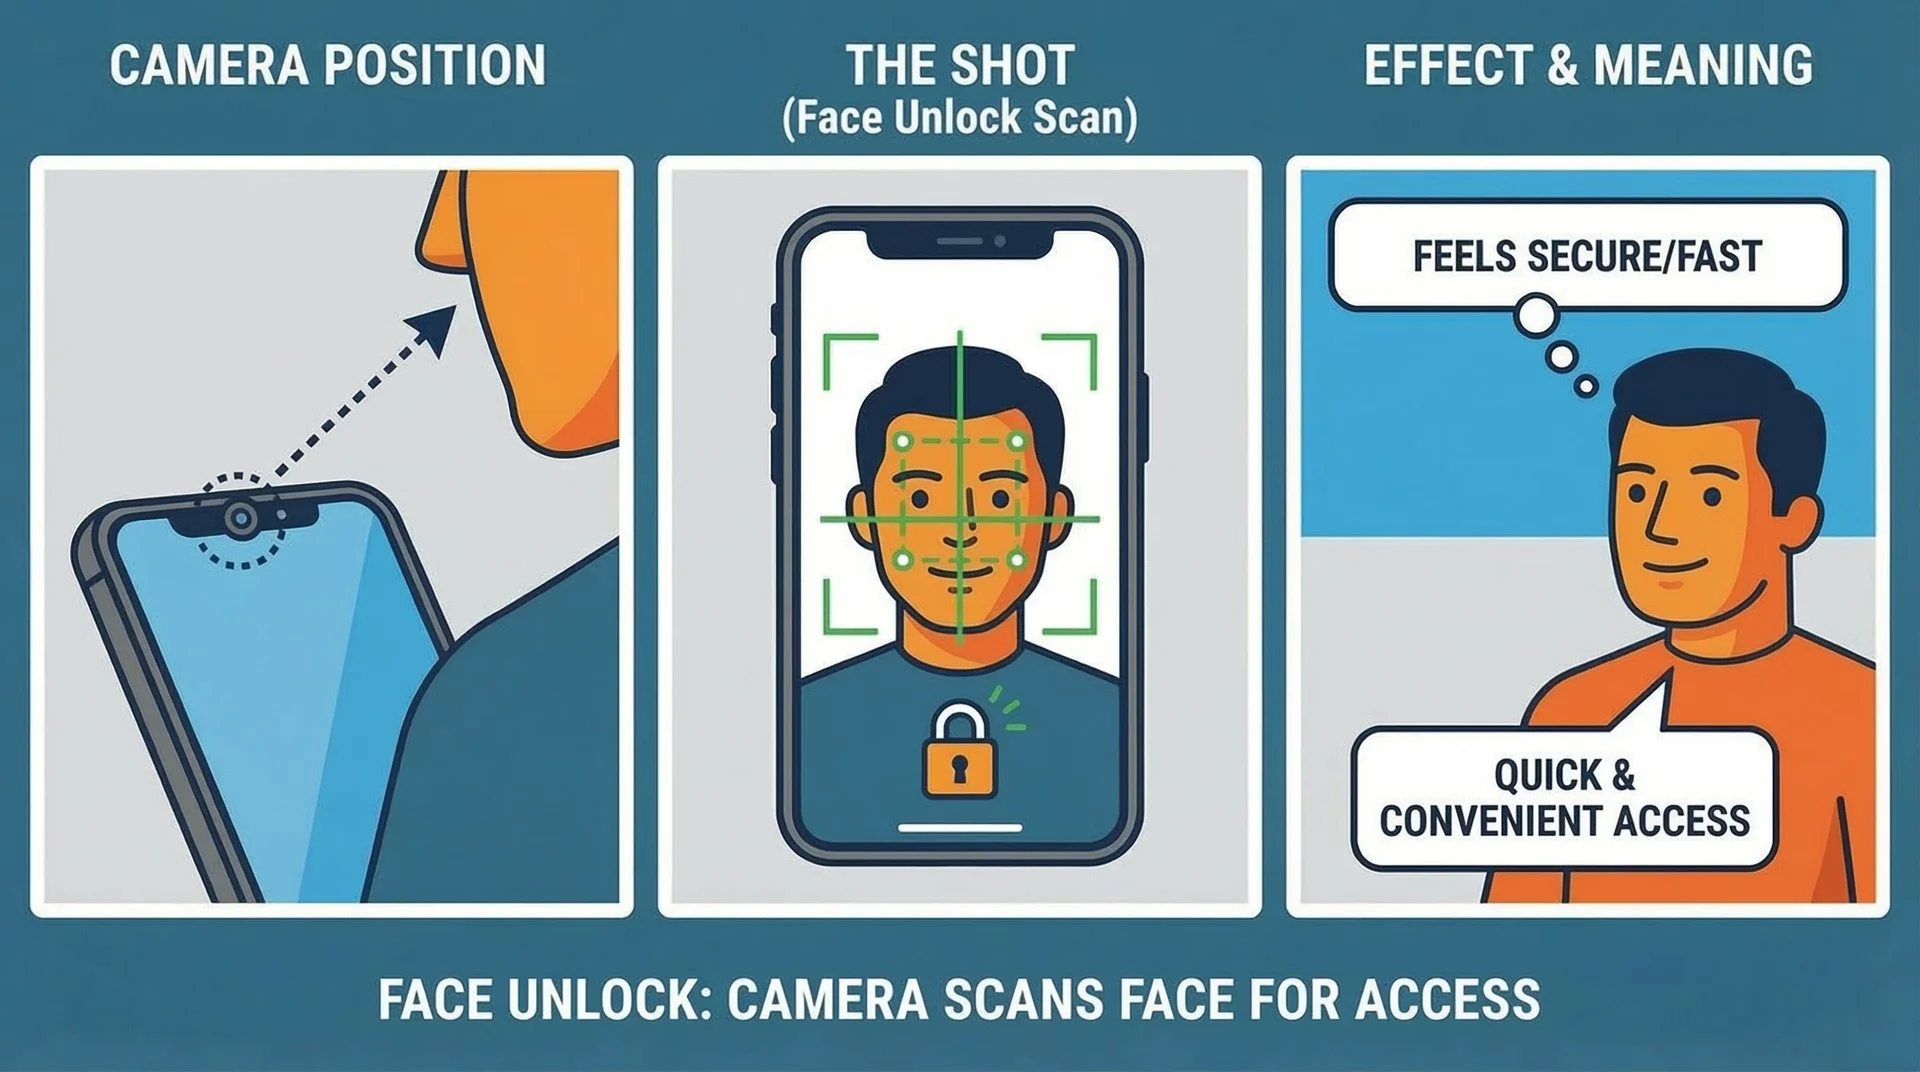
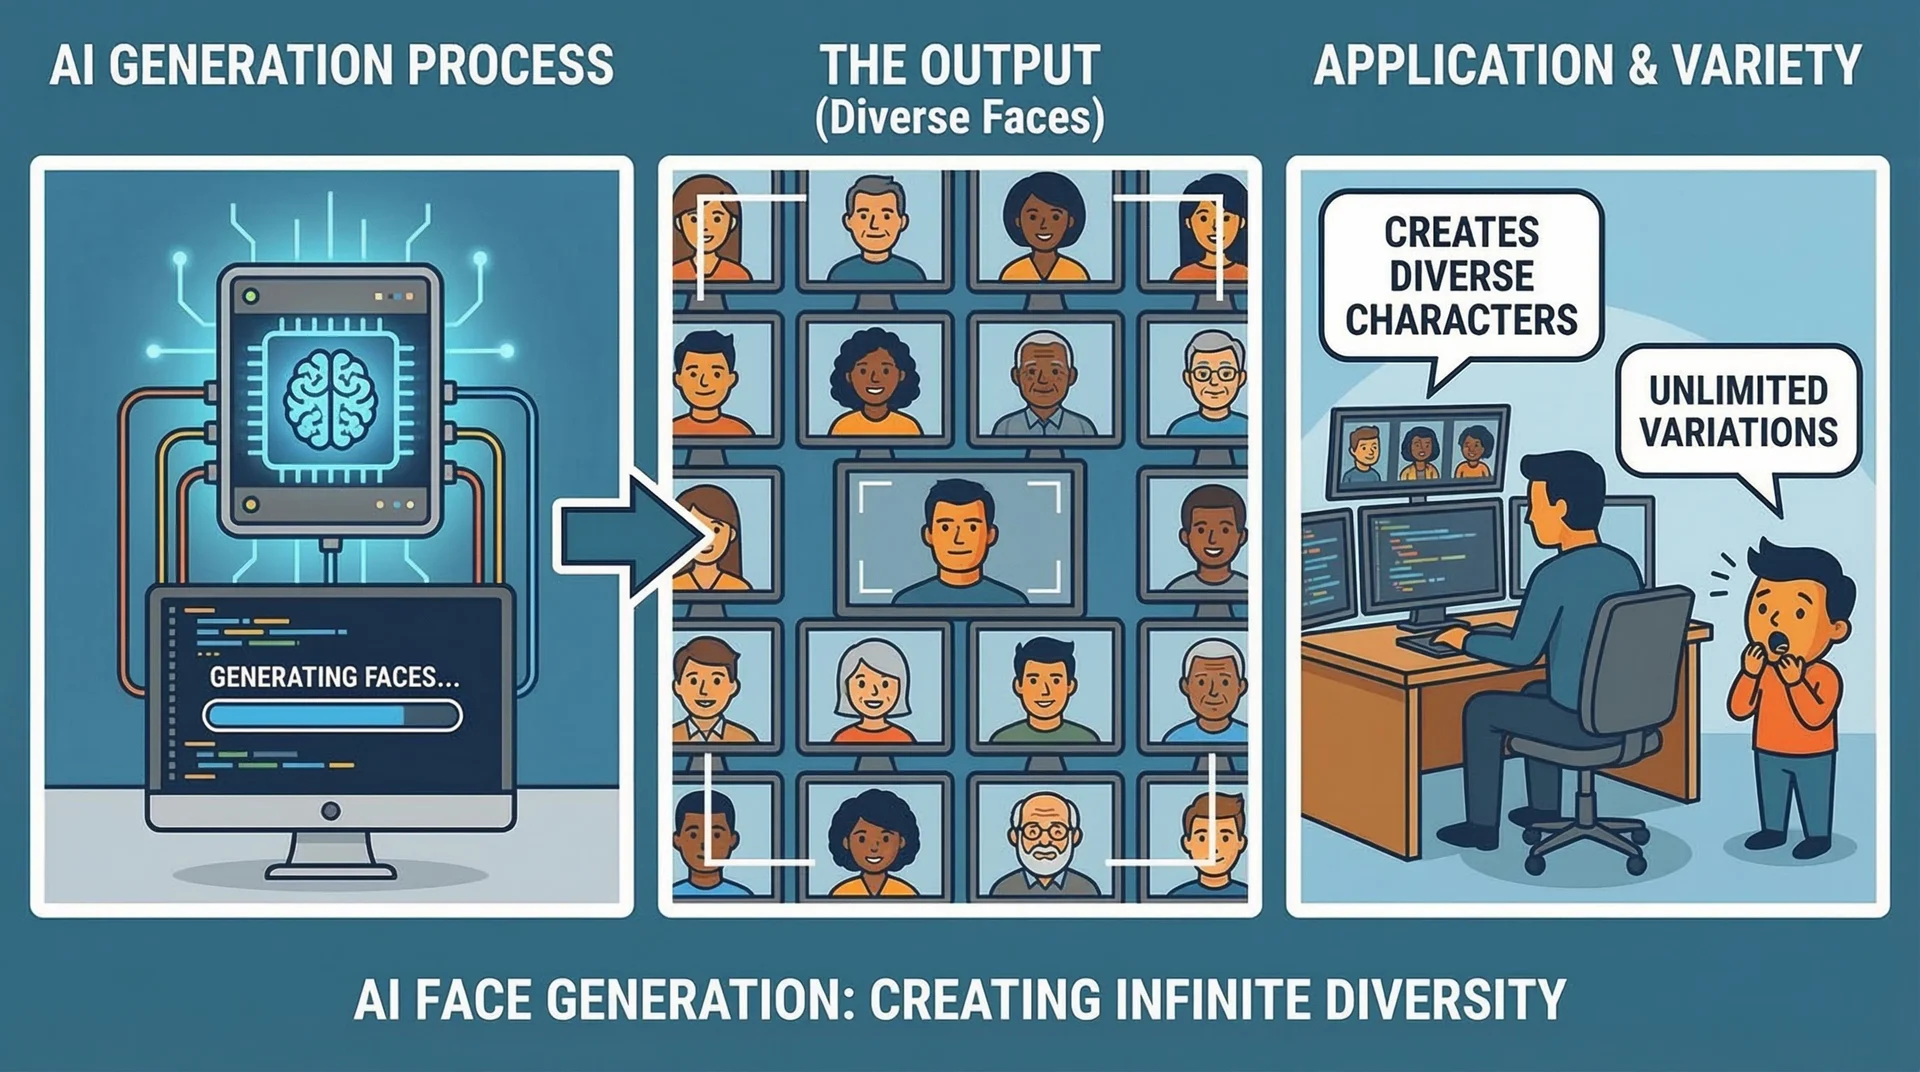
第1段階:想像、概念の図書館
何かを描く前に、モデルは潜在空間と呼ばれる場所でアイデアを探します。本ではなく「特徴」が並ぶ巨大な図書館を思い浮かべてください。似たものどうしが近くに集まっていて、「ふわふわ」のコーナー、「機械」のコーナー、「食べ物」のコーナーがあります。
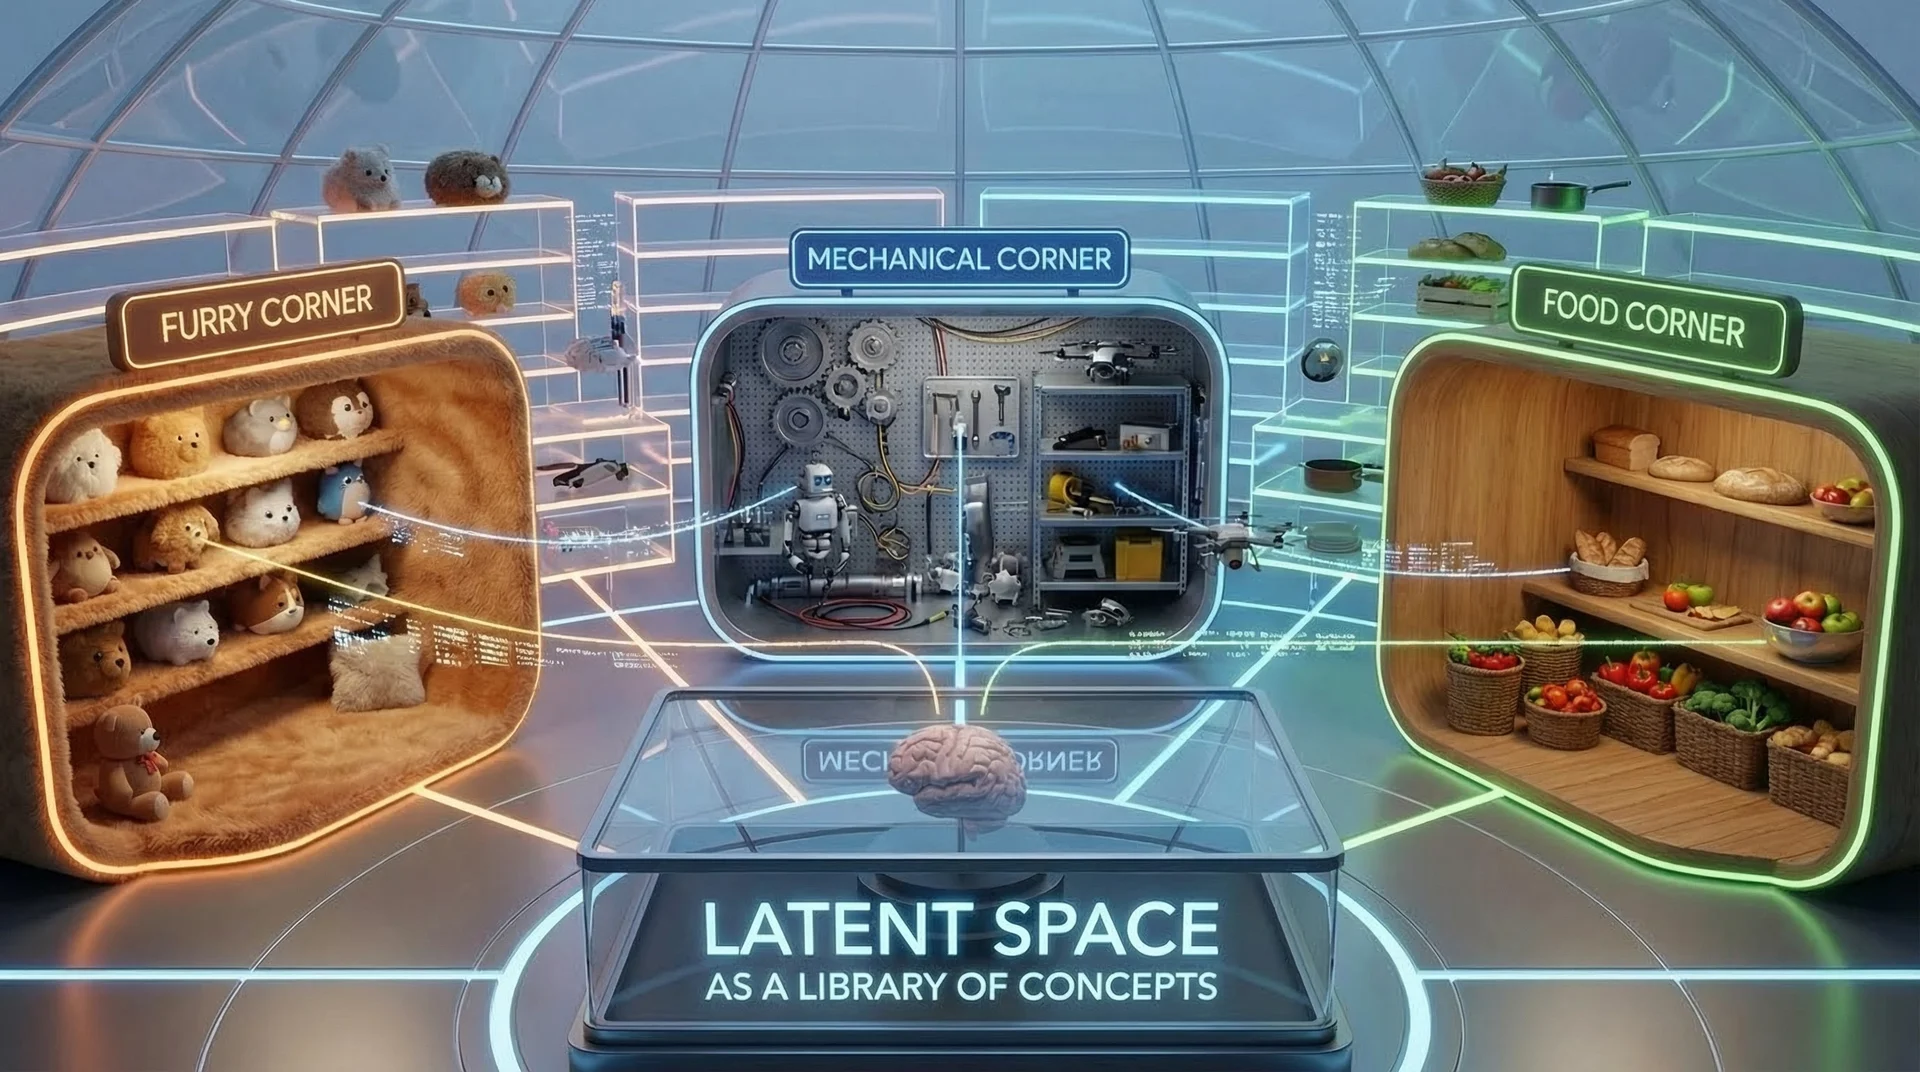
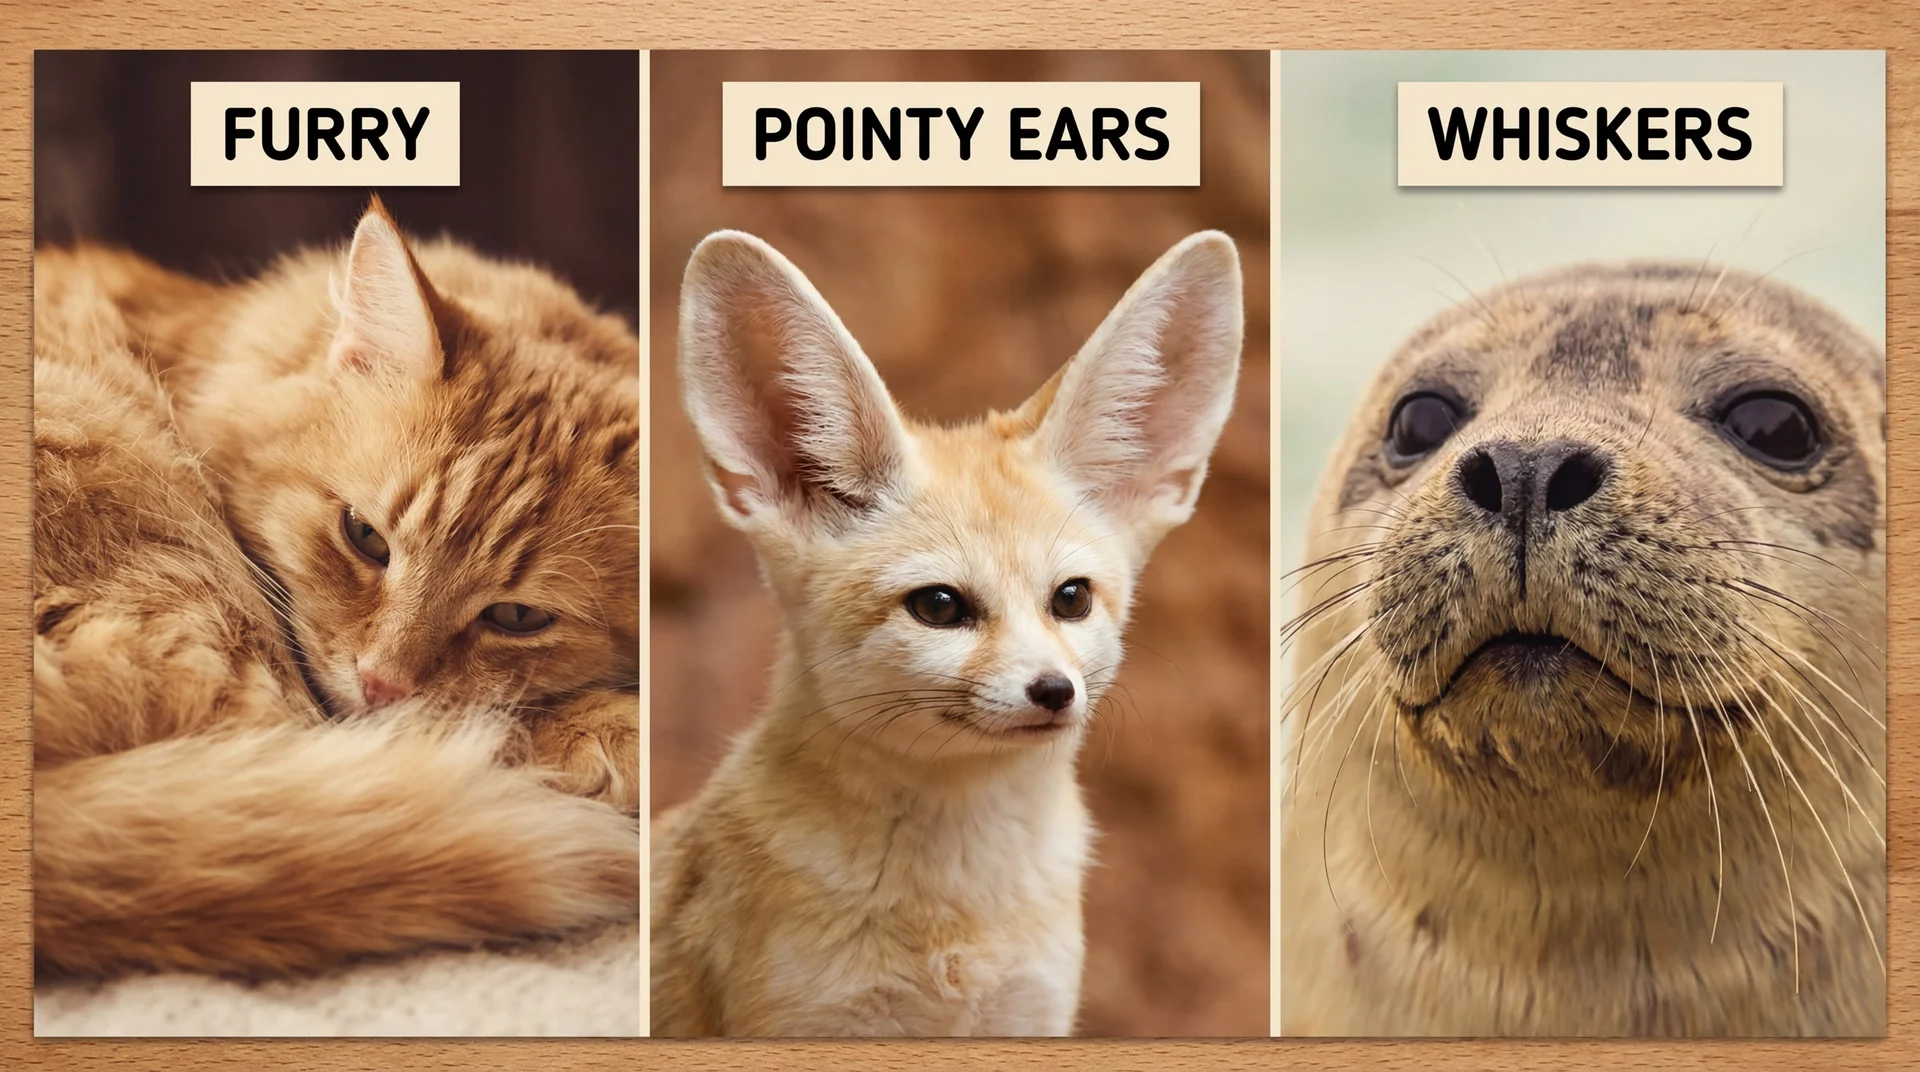
猫を頼むと、モデルは「ふわふわ」「とがった耳」「ひげ」が交わる地点へ向かいます。ロボット猫なら、「機械」のコーナーと「ふわふわ」のコーナーのちょうど中間です。記憶の中の猫をコピーするのではなく、そこで見つけたレシピから新しい猫を組み立てるのです。
第2段階:生成、ノイズから画像へ
画像モデルは拡散と呼ばれるプロセスを使います。電波の入っていないテレビのような、ランダムなノイズの画面から始めます。「ピザを食べている猫」というプロンプトなら、モデルは「この点々を少し変えたら、もっと猫らしく見えるだろうか?」と考えます。これを何度も繰り返してノイズを少しずつ取り除き、鮮明な画像を浮かび上がらせます。
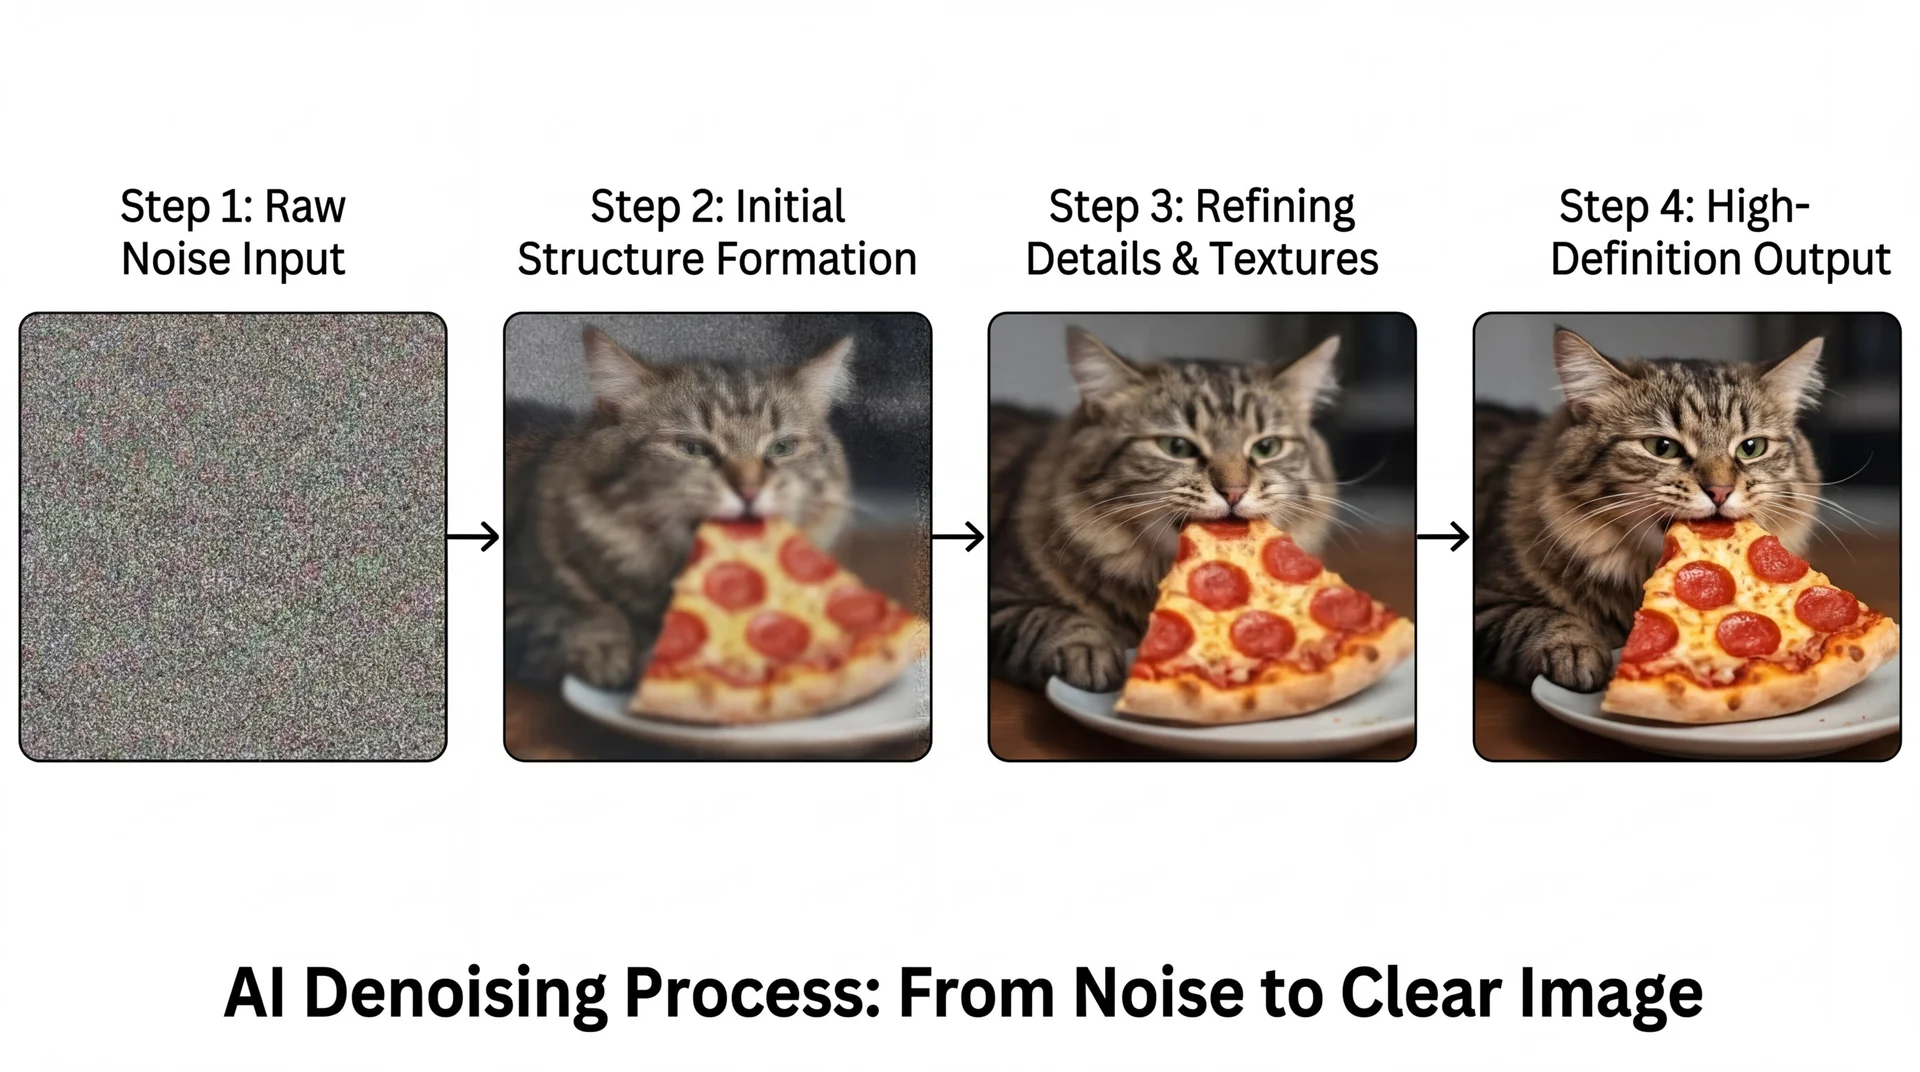
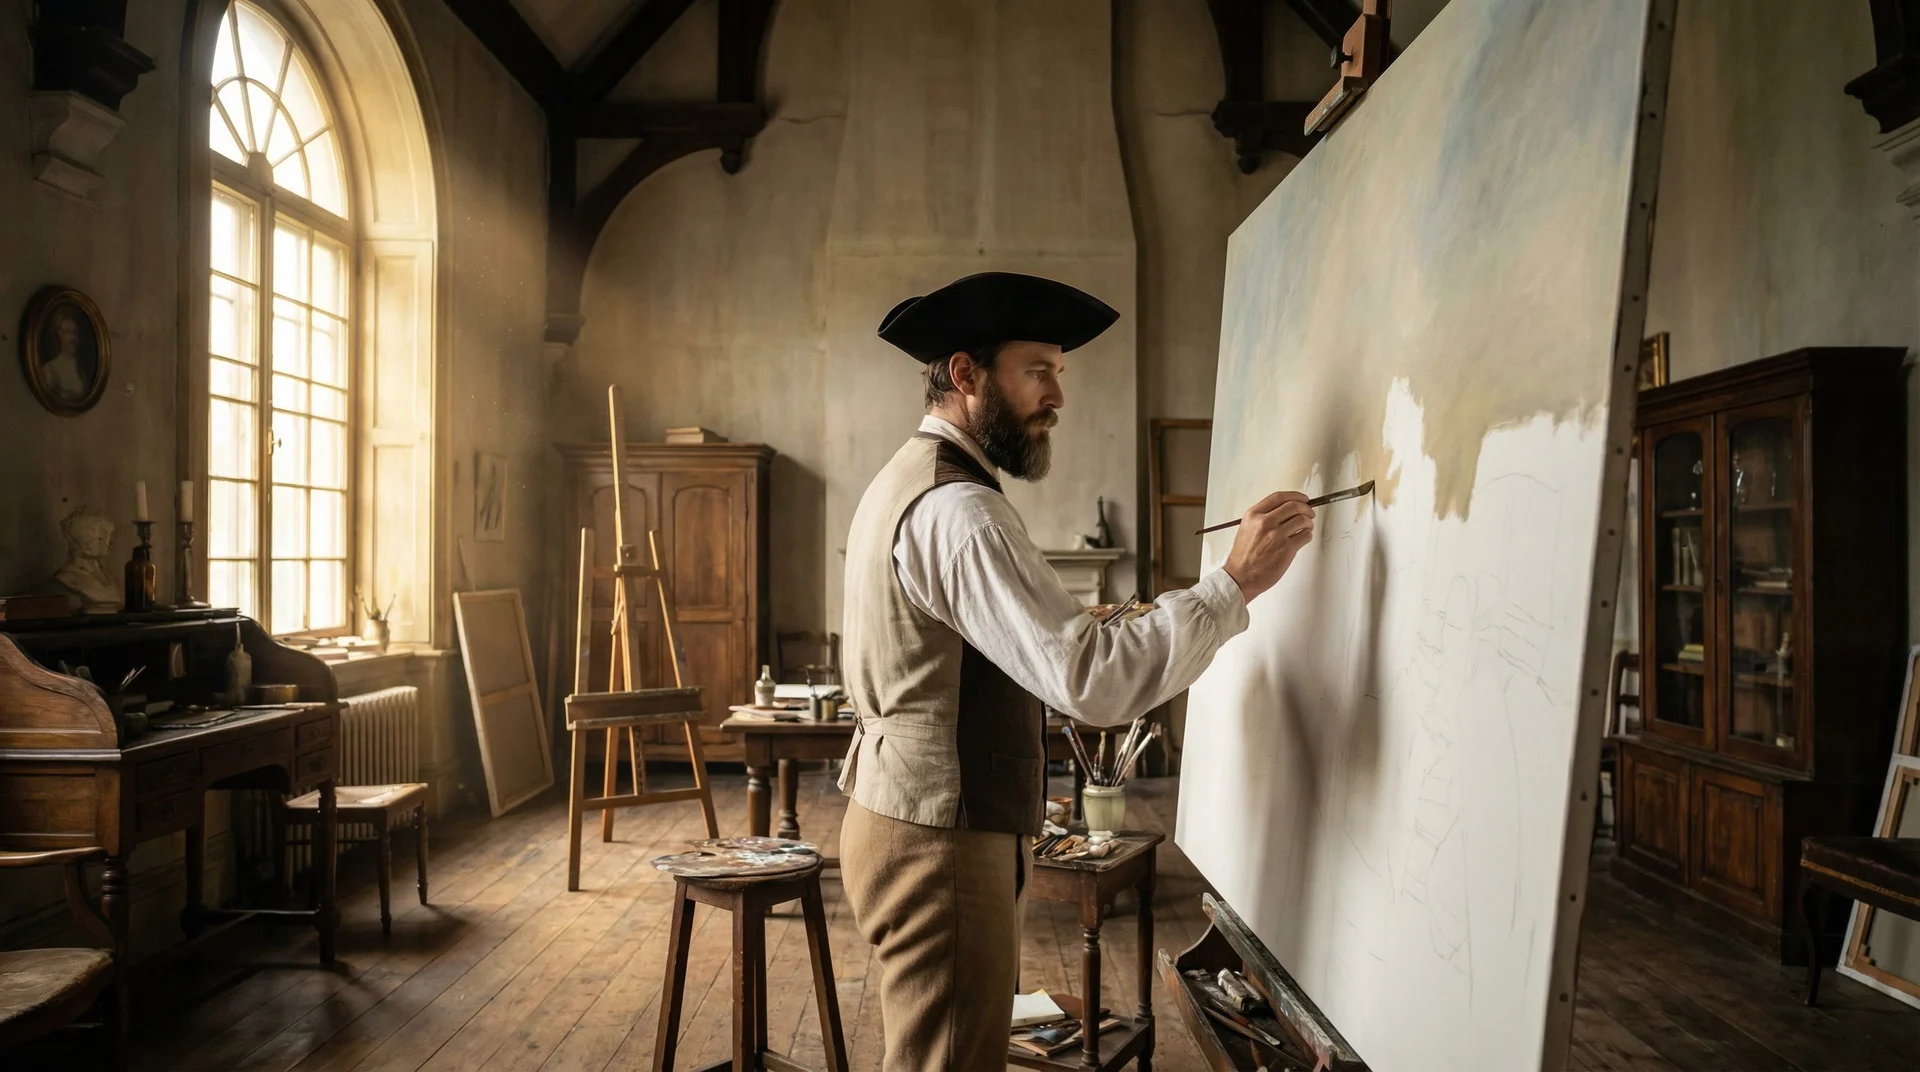
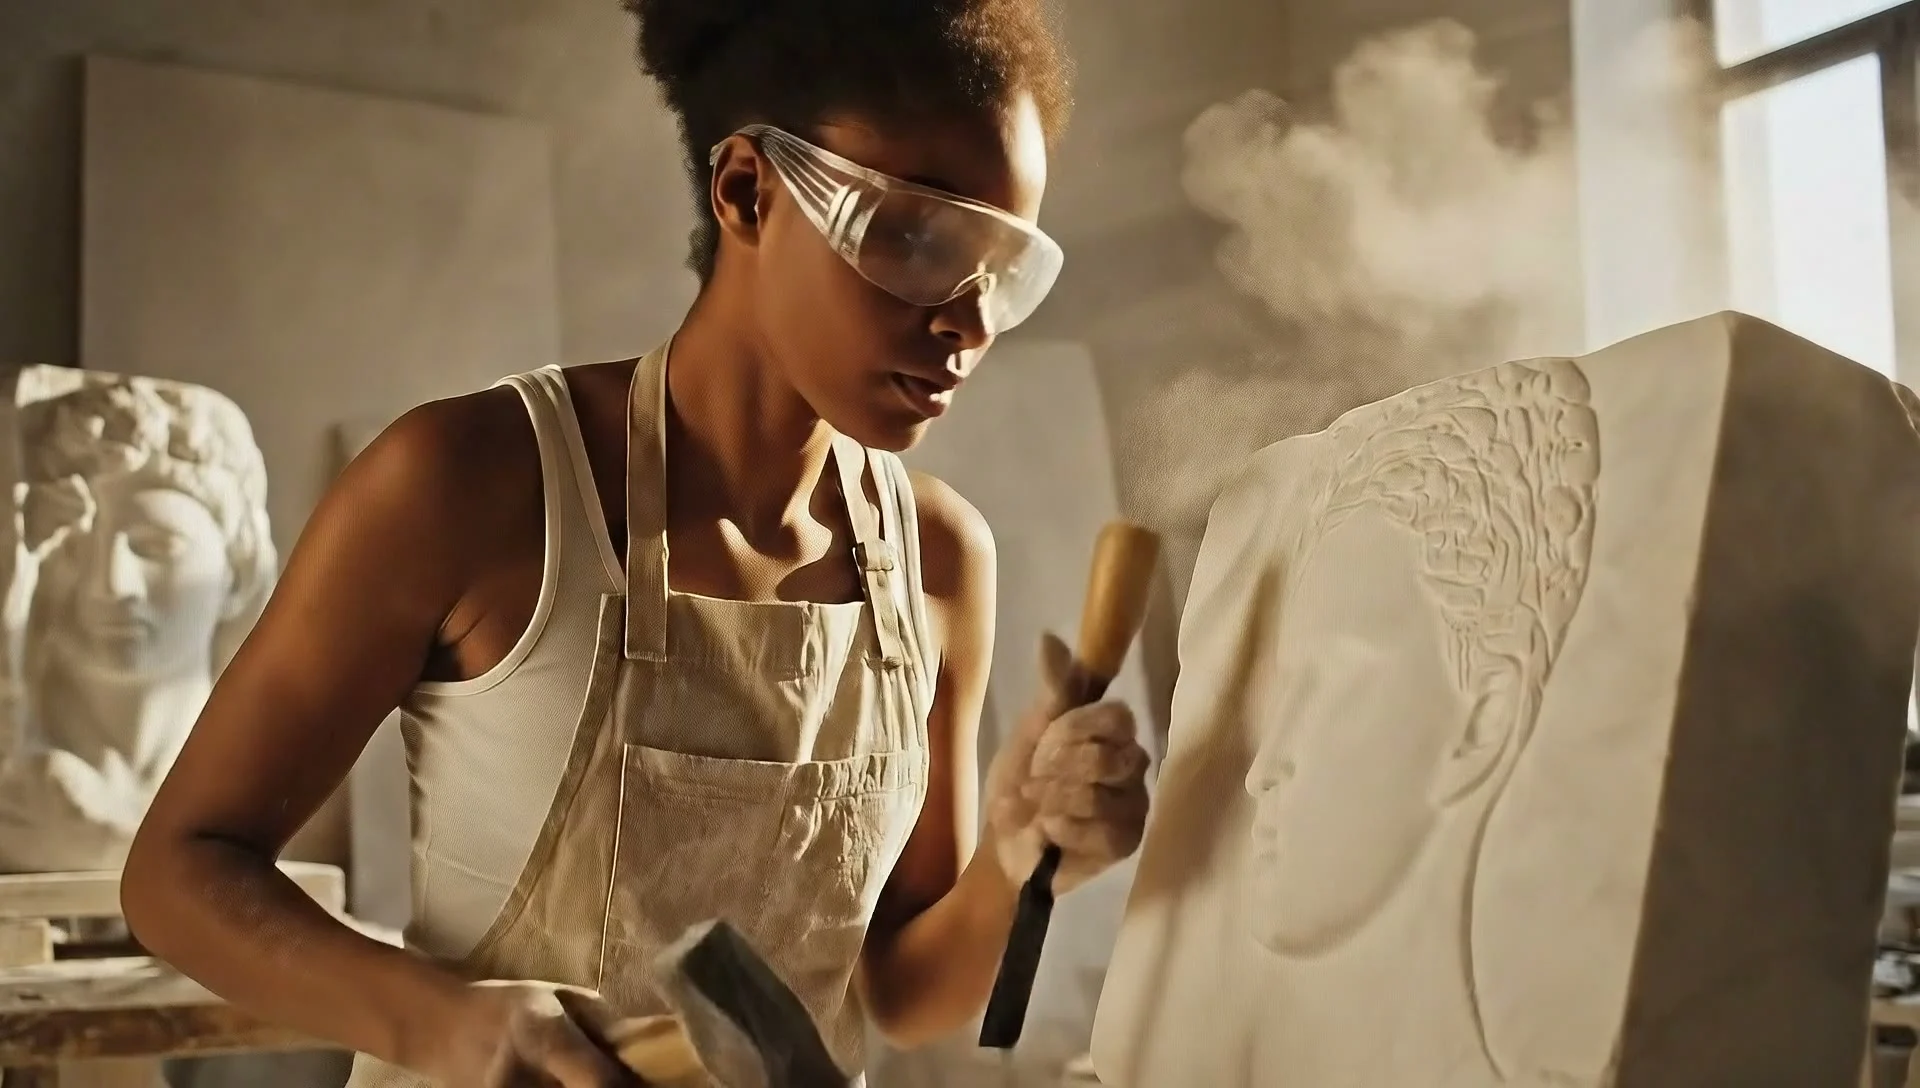
だから、絵を描くというより彫刻に近いのです。画家は真っ白なキャンバスに絵の具を足していきますが、モデルはノイズを削って画像を浮かび上がらせます。
AIはどのように動画を生成するのか
動画は時間が加わるぶん、さらに難しくなります。猫の画像を24枚別々に生成すると、少しずつ違う24匹の猫ができてしまい、つなげて再生するとちらつきます。動画モデルは、パラパラ漫画の全ページを一度に描きます。1枚のフレームを描くあいだも前後のフレームを確かめるので、毛の色は変わらず、動きもなめらかにつながります。
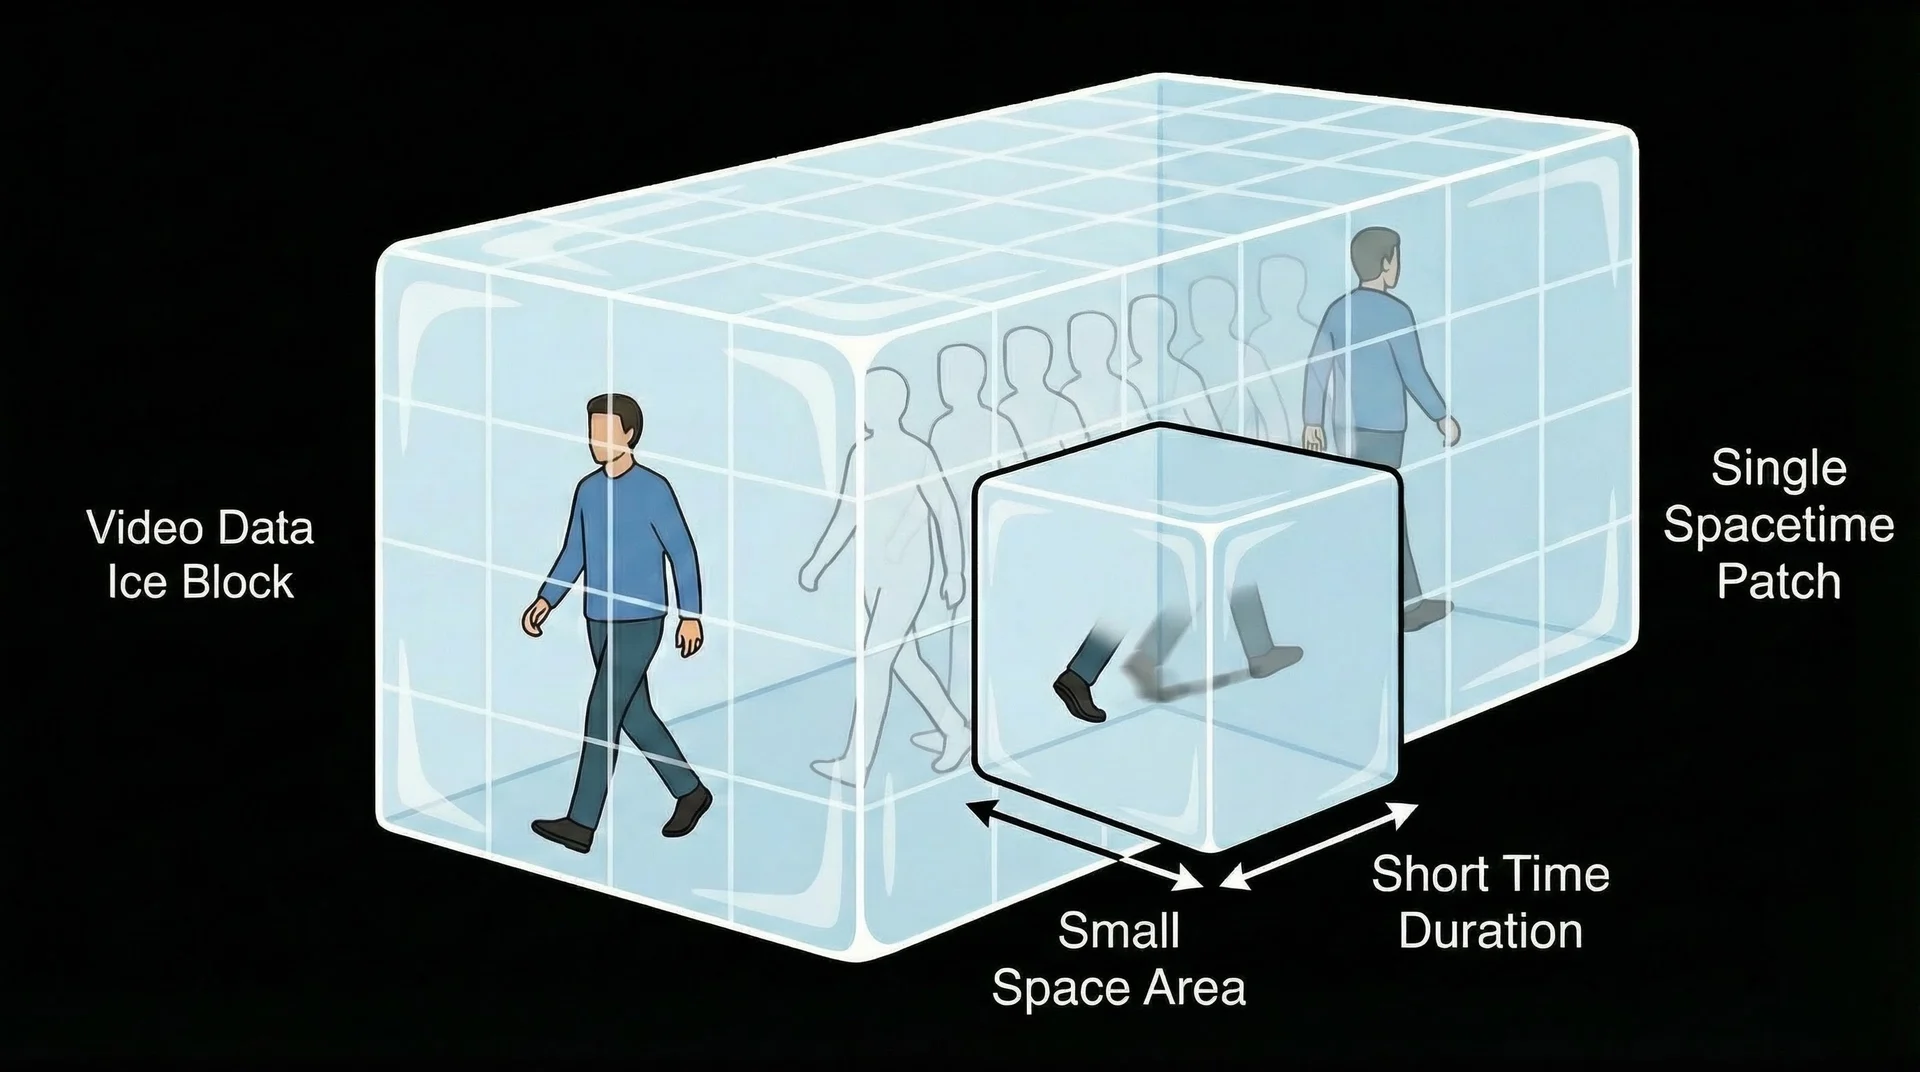
モデルは時空間パッチと呼ばれる小さなブロックで作業します。5秒の動画を氷のかたまりだと想像してください。前面が0秒で、奥行きが時間です。モデルはこのかたまりを何千もの小さな角氷に切り分けます。一つひとつの角氷は、画像の小さな部分の見た目と、その動き方を知っています。動くピースをぴったり組み合わせるからこそ、キャラクターが突然服を変えたり消えたりしないのです。
AIはどうやって猫の見た目を知るのか?
AIは、「猫」というラベルが付いた猫の写真のような、ラベル付きの画像を大量に見て学んでいます。簡単に言えば、写真そのものを取っておくのではなく、「猫にはたいてい、とがった耳が2つ、ひげ、そして毛がある」というレシピを学ぶのです。
AI動画を作るときに役立つこと
用語集
- AIGC:AI生成コンテンツ。AIモデルが作る画像、動画、音楽、文章のこと。
- 潜在空間:モデルが持つ概念の地図。似たアイデアどうしが近くに集まっています。
- 拡散:ランダムなノイズから始めて、少しずつノイズを取り除いて画像を作る方法。
- 時空間パッチ:動画の小さなかけら。画像の一部分と、それが短い時間にどう動くかの両方を持っています。
よくある質問
AIGCとは何の略ですか?
AI-generated content(AI生成コンテンツ)の略です。AIモデルが分析するだけでなく、自ら作り出す画像、動画、音楽、文章のことです。
AIGCと従来のAIの違いは何ですか?
従来のAIは、スマホの顔認証のように、すでに存在するものを認識して分類します。AIGCは、これまで存在しなかった顔の画像のように、リクエストから新しいものを作ります。
AI画像生成はどのような仕組みですか?
まず概念の地図である潜在空間でアイデアを見つけ、次に拡散を使います。ランダムなノイズから始めて、プロンプトに合う画像になるまで少しずつノイズを取り除いていきます。
AI動画がAI画像より難しいのはなぜですか?
動画には時間が加わるからです。モデルはすべてのフレームを一貫させる必要があるため、1枚ずつ描くのではなく、小さな時空間パッチに分けて映像全体をまとめて生成します。
文字起こし
0:00 · AIGCとは
AIGCとは何でしょうか?AI生成コンテンツとは、既存のデータを分析するだけでなく、新しいコンテンツを生み出せるAIのことです。従来のAIは、パターンを認識することに重点を置いています。例えば、顔でスマホのロックを解除するように。AIGCが重視するのは「創造」です。現実の世界にはこれまで存在しなかった新しい顔を生み出すのです。
0:23 · 料理評論家とシェフ
従来のAIは、料理評論家のようなものでした。料理を見せると、それを分析します。「これはパスタ」「これはハンバーガー」「これはケーキ」すでに存在するものを識別し、ラベルを付けるのです。AIGCはシェフのようなものです。料理を見せるのではなく、注文をするのです。「パイナップルとチーズ増量の辛いピザをください」するとキッチンに入り、ゼロから新しい料理を作ります。冷蔵庫から冷凍ピザを出して渡すわけではありません。これまで存在しなかった、出来たてのピザを作るのです。
0:58 · 第1段階:潜在空間での想像
AIはどのように画像を生成するのか第1段階は「想像」です。潜在空間を、コーナー(概念)が並ぶ巨大な図書館だと考えてください。仕組みはこうです。この図書館には本ではなく「特徴」が並んでいます。すべてのものは、ほかのものとどれだけ似ているかで配置されます。巨大な図書館の部屋を想像してください。ある隅は「ふわふわ」のコーナー、ある隅は「機械」のコーナー、そしてある隅は「食べ物」のコーナーです。猫を頼むと、AIは図書館の中のある地点へ飛んでいきます。そこは「ふわふわ」「とがった耳」「ひげ」が交わる場所です。ロボット猫を頼むと、AIはちょうど中間の地点を見つけます。「機械」のコーナーと「ふわふわ」のコーナーの間です。なぜこれが重要なのか。AIは記憶から猫をコピーするのではありません。頭の中にある猫の座標へ行き、その座標で見つけたレシピをもとに、まったく新しい猫を作るのです。
1:56 · 第2段階:拡散による生成
第2段階は「生成」です。アイデアが決まったら、AIはそれを目に見える形にする必要があります。そこで使うのが「拡散」というプロセスです。AIは、ノイズだらけの画面からスタートします。電波の入っていないテレビのような画面です。AIに「ピザを食べている猫を見せて」と伝えると、AIはノイズを見て、こう考えます。「この点を少し変えたら、もっと猫らしく見えるだろうか?」これを何千回も繰り返し、ノイズを取り除いていくと、やがて鮮明な高解像度の画像が現れます。人間が真っ白なキャンバスに絵の具を塗るのとは違い、混沌の中から秩序を彫り出しているのです。
2:37 · AIはどのように動画を生成するのか
AIはどのように動画を生成するのかSora、Runway、Klingのような動画生成は、はるかに難しくなります。新たな次元、「時間」が加わるからです。AIに猫の画像を24枚生成させると、24匹の違う猫ができてしまいます。それをつなげて動画にすると、ちらついて、めちゃくちゃに見えます。動画AIは、パラパラ漫画の全ページを一度に描きます。2ページ目を描くときは、 1ページ目を見て、猫の毛の色が変わっていないか確かめます。3ページ目も見て、動きがなめらかにつながるようにします。ピクセル、つまり小さな点だけを扱うのではなく、AIは「パッチ」を使います。パッチが表すのは、空間(画像の一部分)と、時間(その部分が数秒間でどう動くか)の両方です。タイムライン全体を一度に作ることで、ストーリーが最初から最後まで筋が通るようにします。
3:29 · AIが猫の見た目を学ぶ方法
では、AIはどうやって猫の見た目を知るのでしょうか?AIはインターネット上のラベル付き画像を何十億枚も見てきました。例えば、「猫」とラベルが付いた猫の写真です。写真を丸暗記するわけではありません。その代わりに、ものごとの数学的な「レシピ」を学びます。猫のJPEG画像を保存するのではなく、「概念」を保存します。猫にはたいてい、とがった耳が2つ、ひげ、そして毛がある、と。
3:56 · 一番難しいところ:時空間パッチ
ここが一番難しいところです。動画を作るには、AIは動きがなめらかで、時間を通して一貫しているよう保たなければなりません。そのために、動画を画像と時間の両方を含む3Dのデータブロックに分けます。5秒の動画を、透明な氷の大きなかたまりだと想像してください。ブロックの前面がスタート、つまり0秒です。奥行きが時間で、いちばん奥が5秒です。AIはこの巨大な氷のかたまりを何千個もの小さな角氷に切り分けます。一つひとつの角氷、つまり時空間パッチは、動くパズルのピースです。各ピースは、画像の小さな部分がどう見えるか、そしてその数秒間にどう動くべきかを正確に知っています。なぜうまくいくのか。動く角氷をぴったりつなぎ合わせることで、AIは、キャラクターが突然服を変えたり、動いたときに消えたりしないようにします。時間と動きが、ブロックの中に組み込まれているからです。
4:50 · まとめ:彫刻家とパラパラ漫画の作家
画像AIは、ノイズのかたまりを少しずつ削っていく彫刻家のように、絵を浮かび上がらせます。動画AIは、全ページを一度に描くパラパラ漫画の作家のように、ストーリーをなめらかに進めるのです。