第 1 單元 · 第 1 課,共 6 課
什麼是 AIGC?AI 如何生成圖片和影片
AIGC(AI 生成內容,AI-generated content)是能創造新東西的 AI,例如一張圖片、一段影片、一首歌或一段文字,而不只是辨識已經存在的東西。圖片模型會先在一座「概念圖書館」裡找到這個想法,再一步步去除隨機雜訊,直到出現一張符合描述的畫面。影片模型在時間上做同樣的事,所以整段影片從第一格到最後一格都能保持一致。
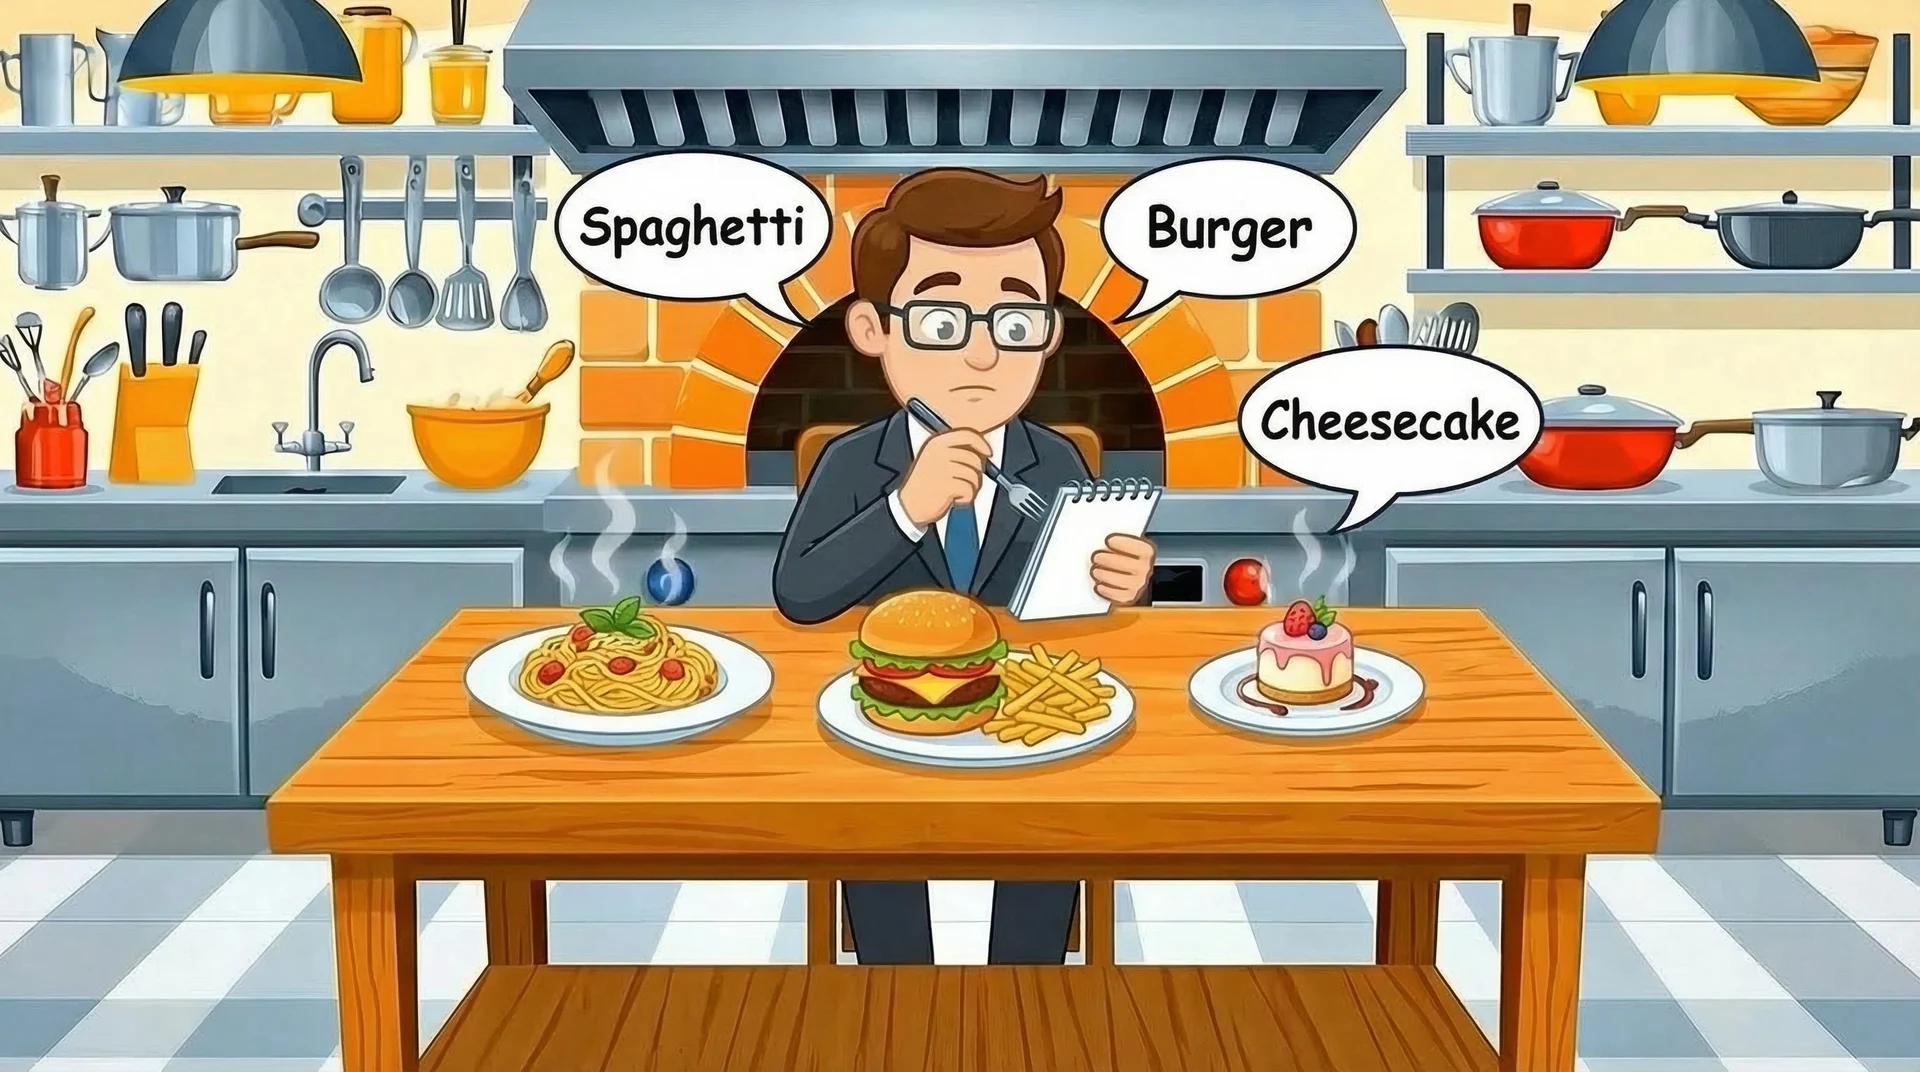
AIGC 和傳統 AI:美食評論家與廚師
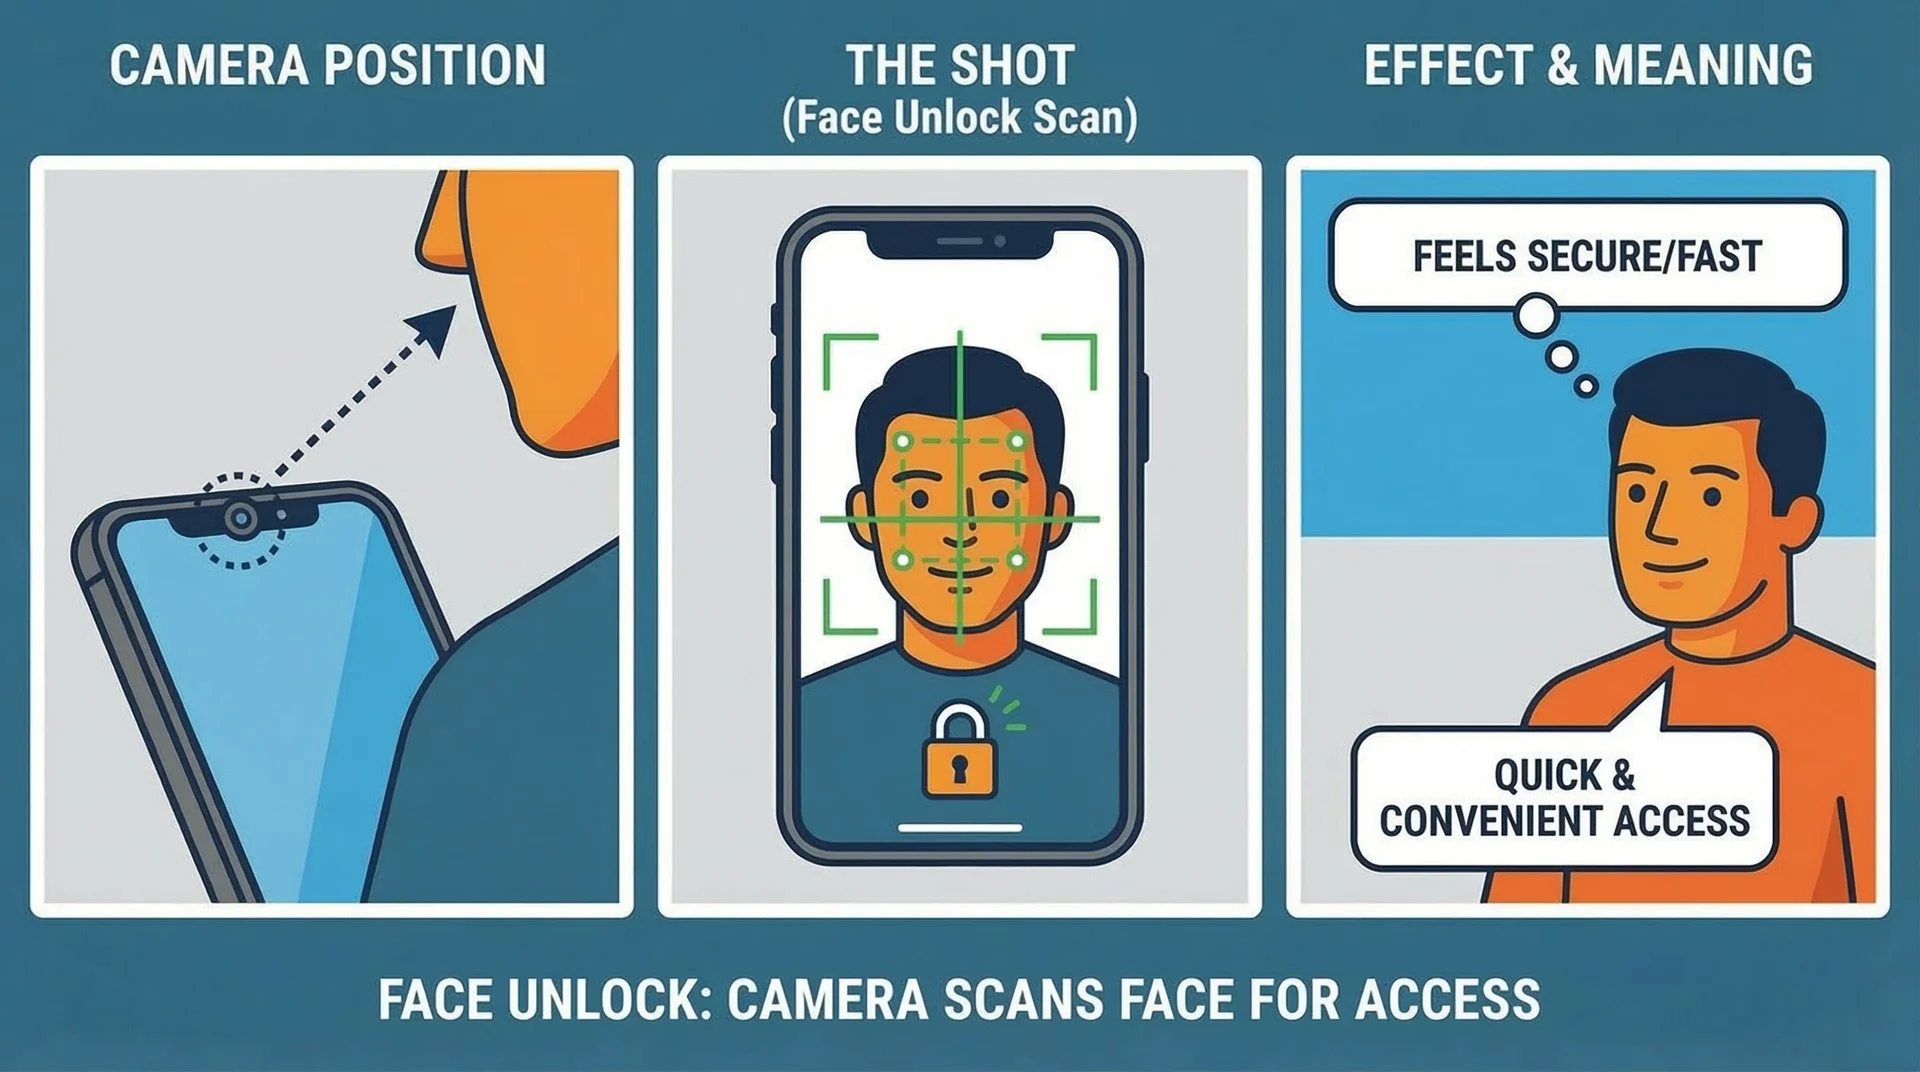
傳統 AI 辨識已經存在的東西。它就像一位美食評論家:給它看一道菜,它會告訴你「這是義大利麵,這是漢堡,這是蛋糕。」用臉部解鎖手機也是同樣的原理。
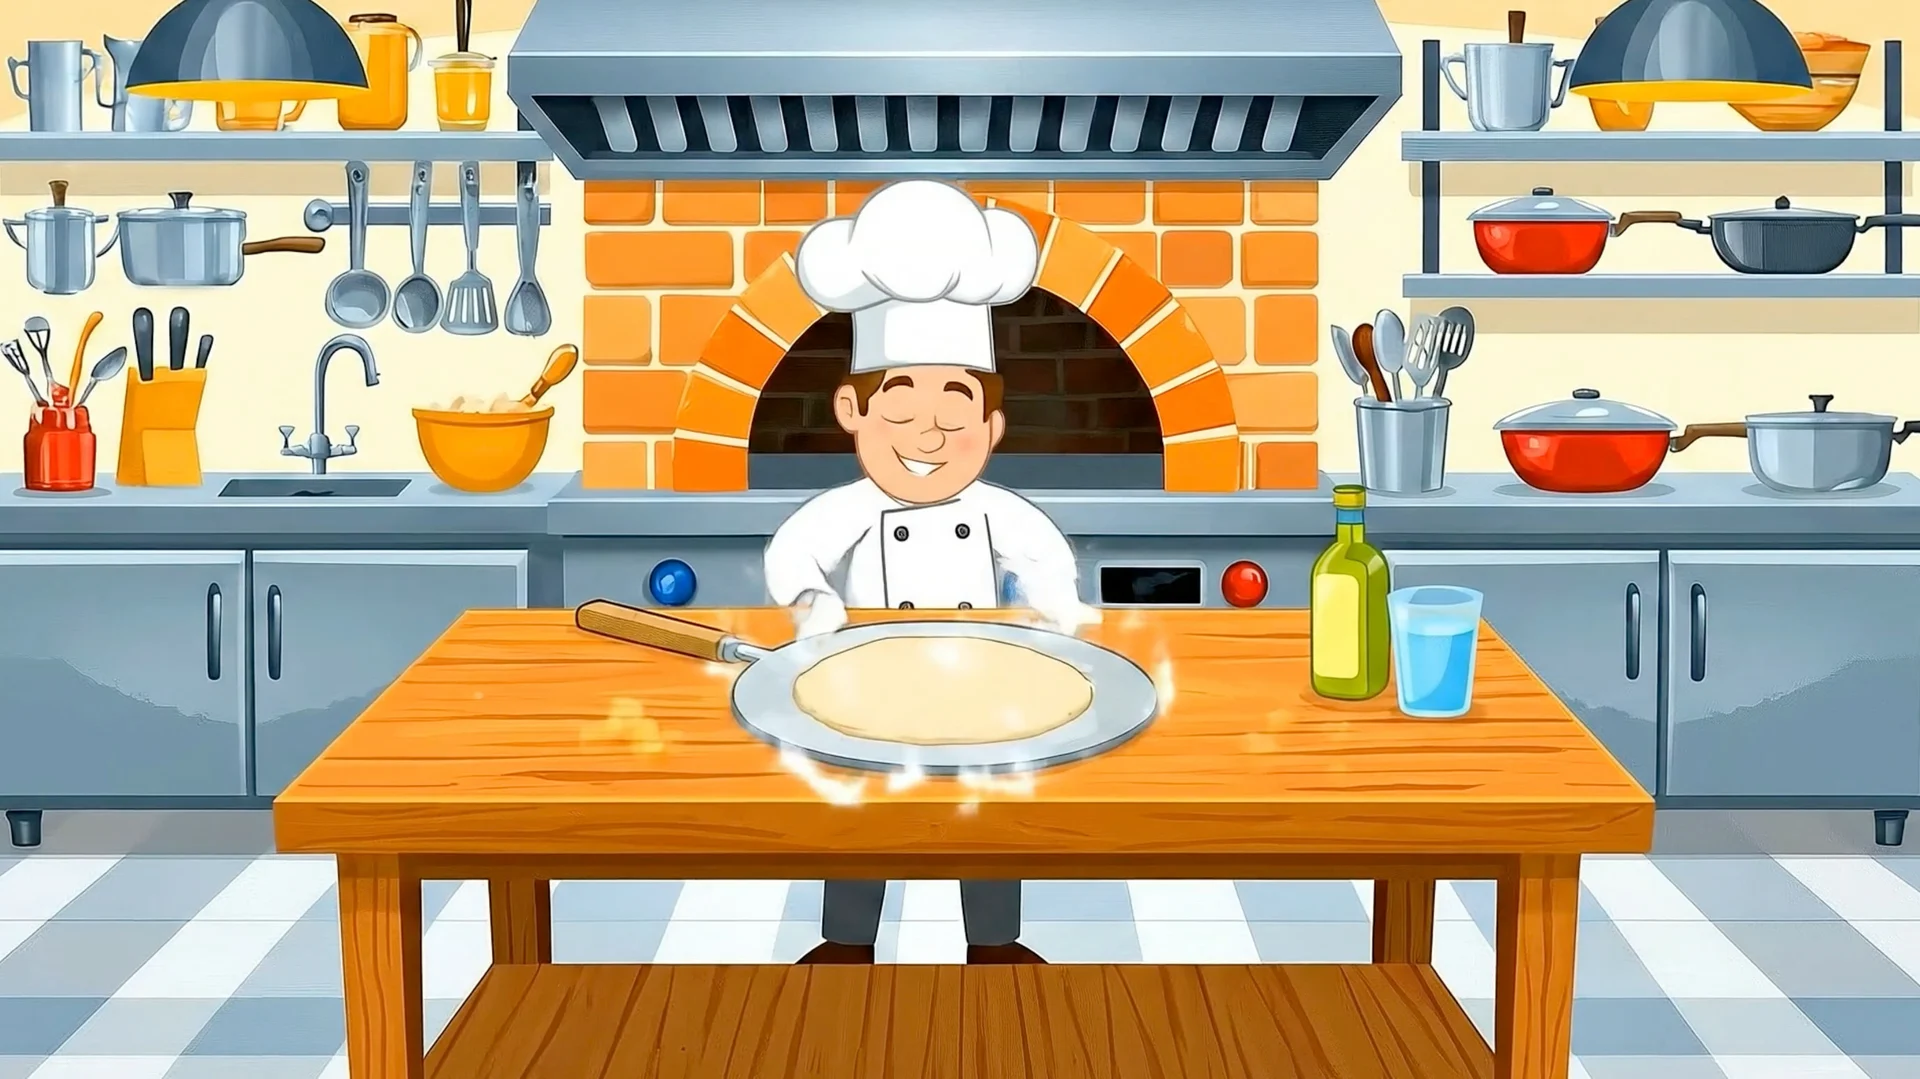
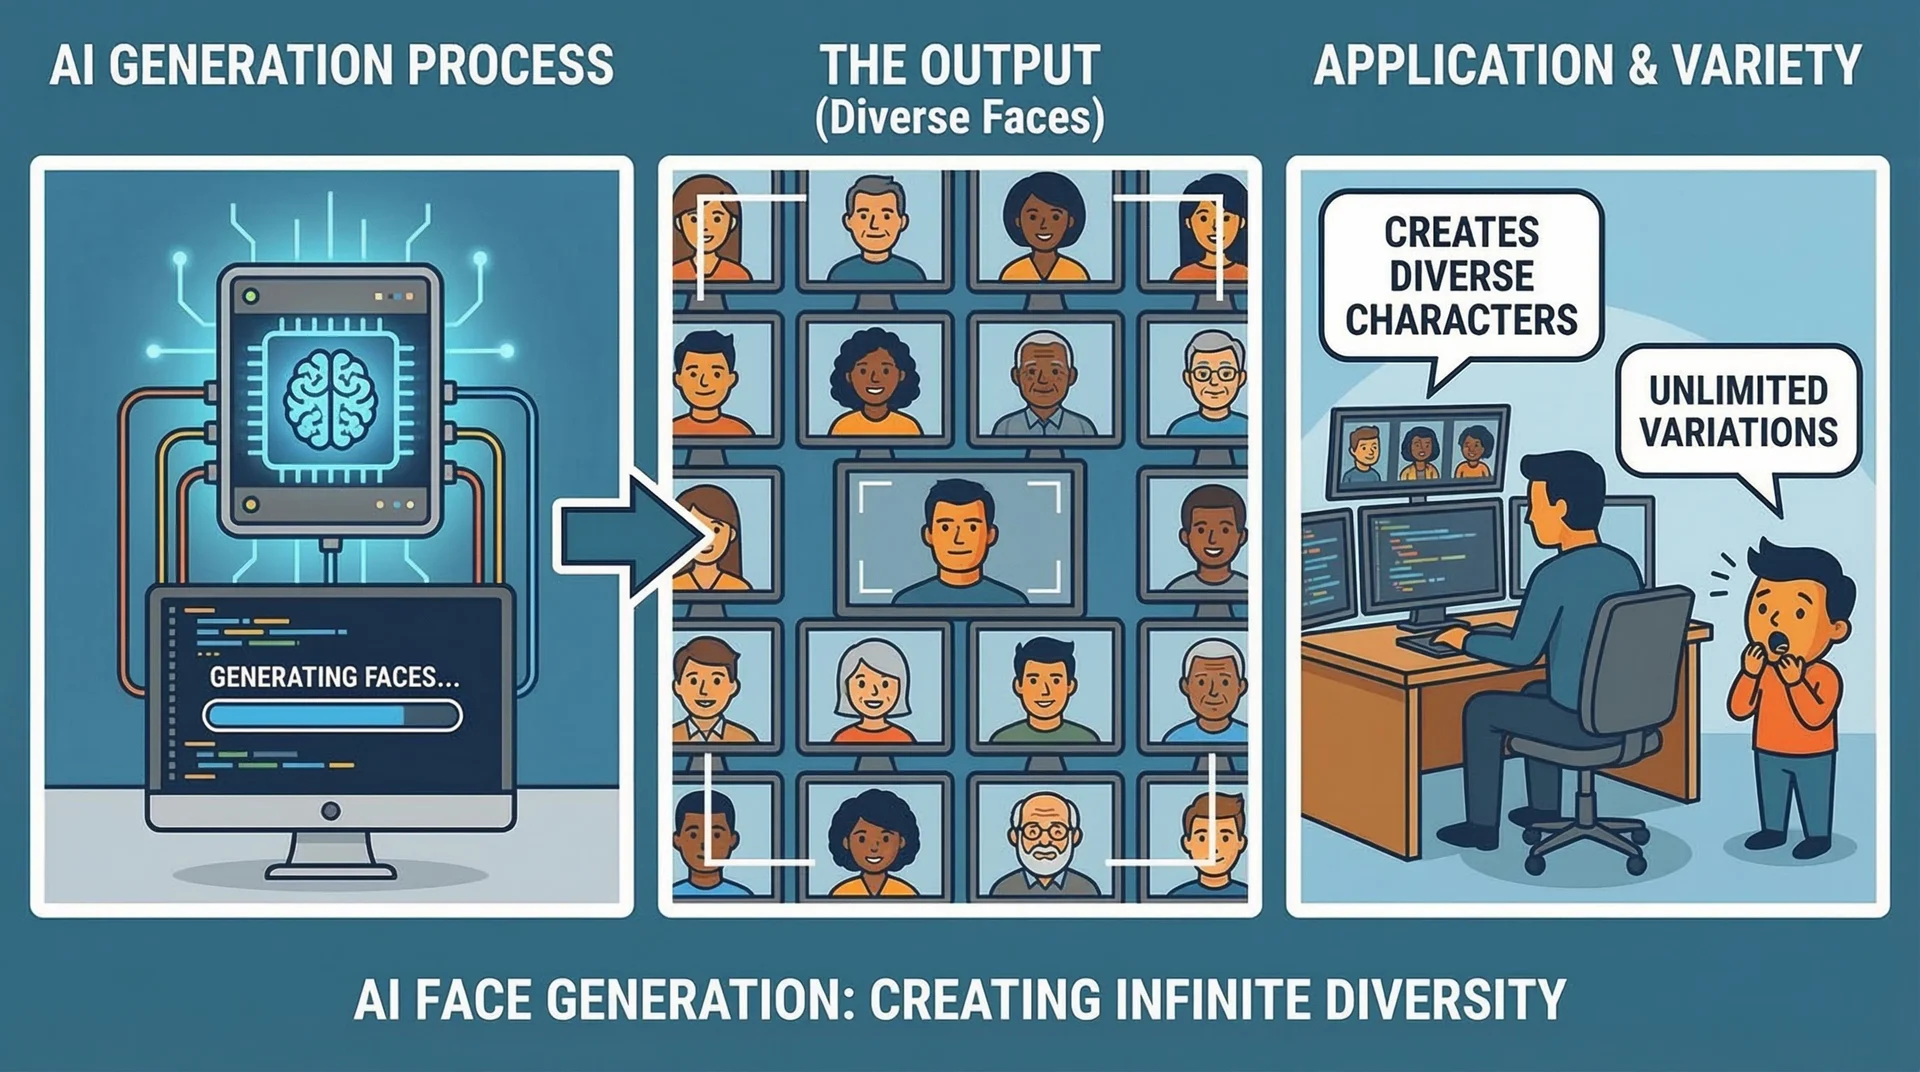
AIGC 則像一位廚師。你不用給它看任何食物,而是向它點餐,例如「一份加鳳梨、多加起司的辣味披薩」,它就會從零開始做出一道新菜,而不是從冰箱裡拿一個冷凍披薩給你。同樣地,它也能畫出一張從未存在過的臉。
第 1 步:想像,一座概念圖書館
動筆之前,模型會先在所謂的潛在空間裡找到這個想法。把它想像成一座巨大的圖書館:裡面沒有書,只有屬性,相似的東西彼此靠得很近,例如毛茸茸角、機械角和食物角。
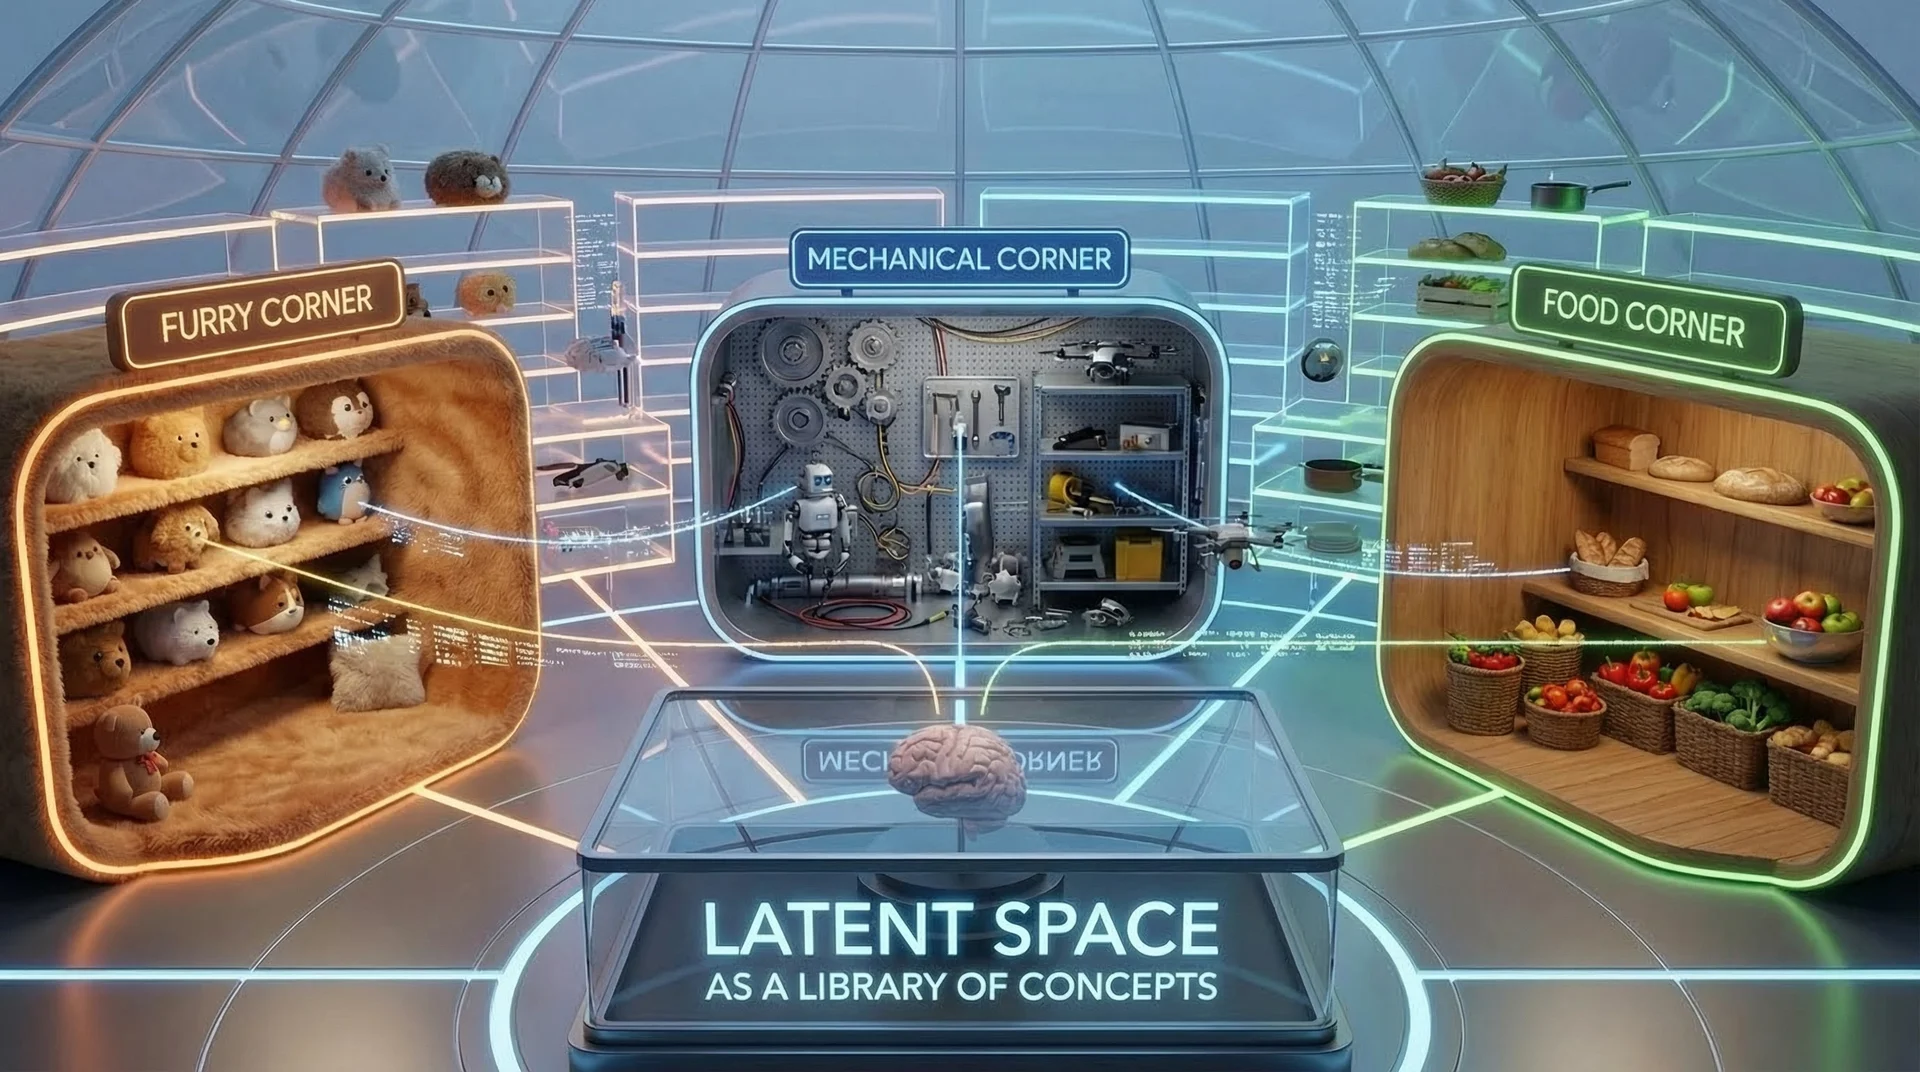
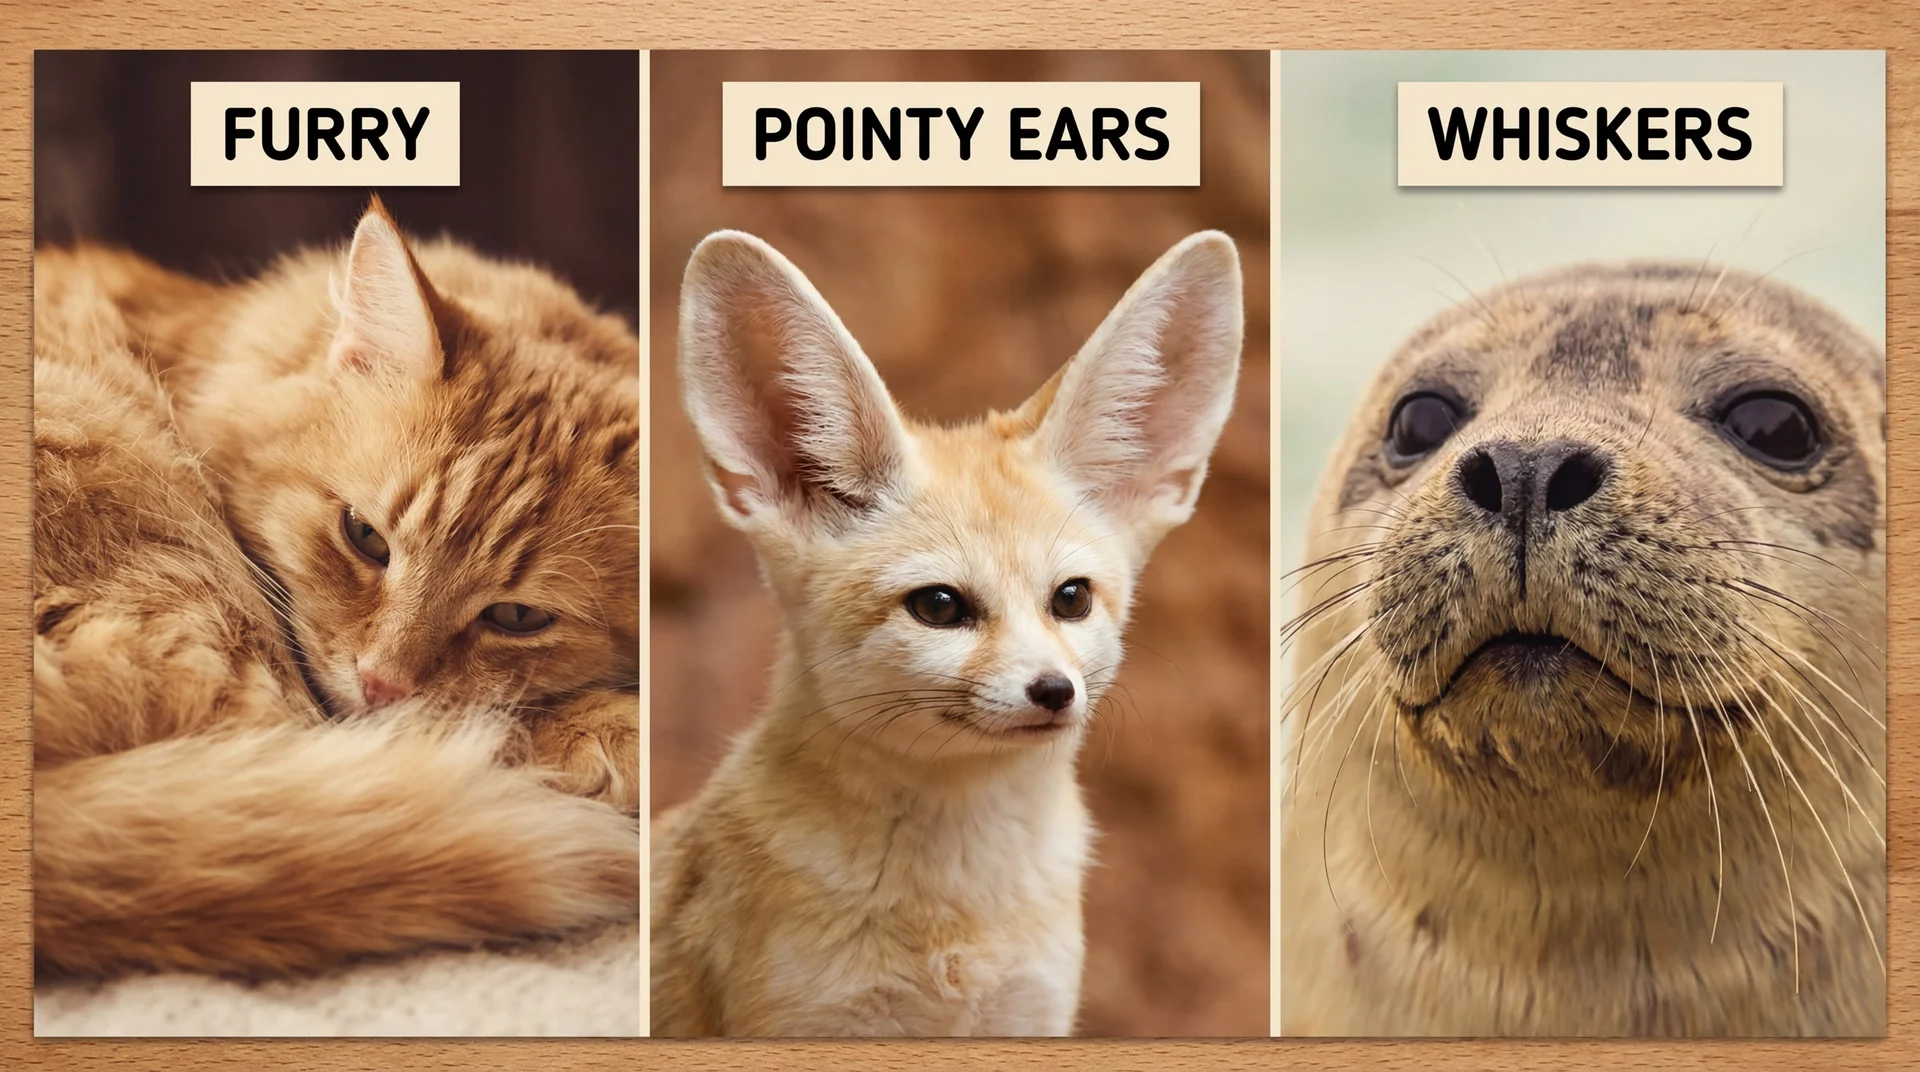
你要一隻貓,模型就會去「毛茸茸」「尖耳朵」和「鬍鬚」交會的地方。你要一隻機器貓,它就會去機械角和毛茸茸角正中間的位置。它不是從記憶裡複製一隻貓,而是照著在那裡找到的配方,造出一隻全新的貓。
第 2 步:創造,從雜訊到畫面
圖片模型使用一種叫擴散的過程。它從滿滿一整個畫面的隨機雜訊開始,就像沒有訊號的電視。拿到「一隻正在吃披薩的貓」這樣的提示詞,模型會問自己:如果我把這些點稍微改一改,會不會更像一隻貓?它把這個過程重複很多次,一步步去除雜訊,直到出現一張清晰的畫面。
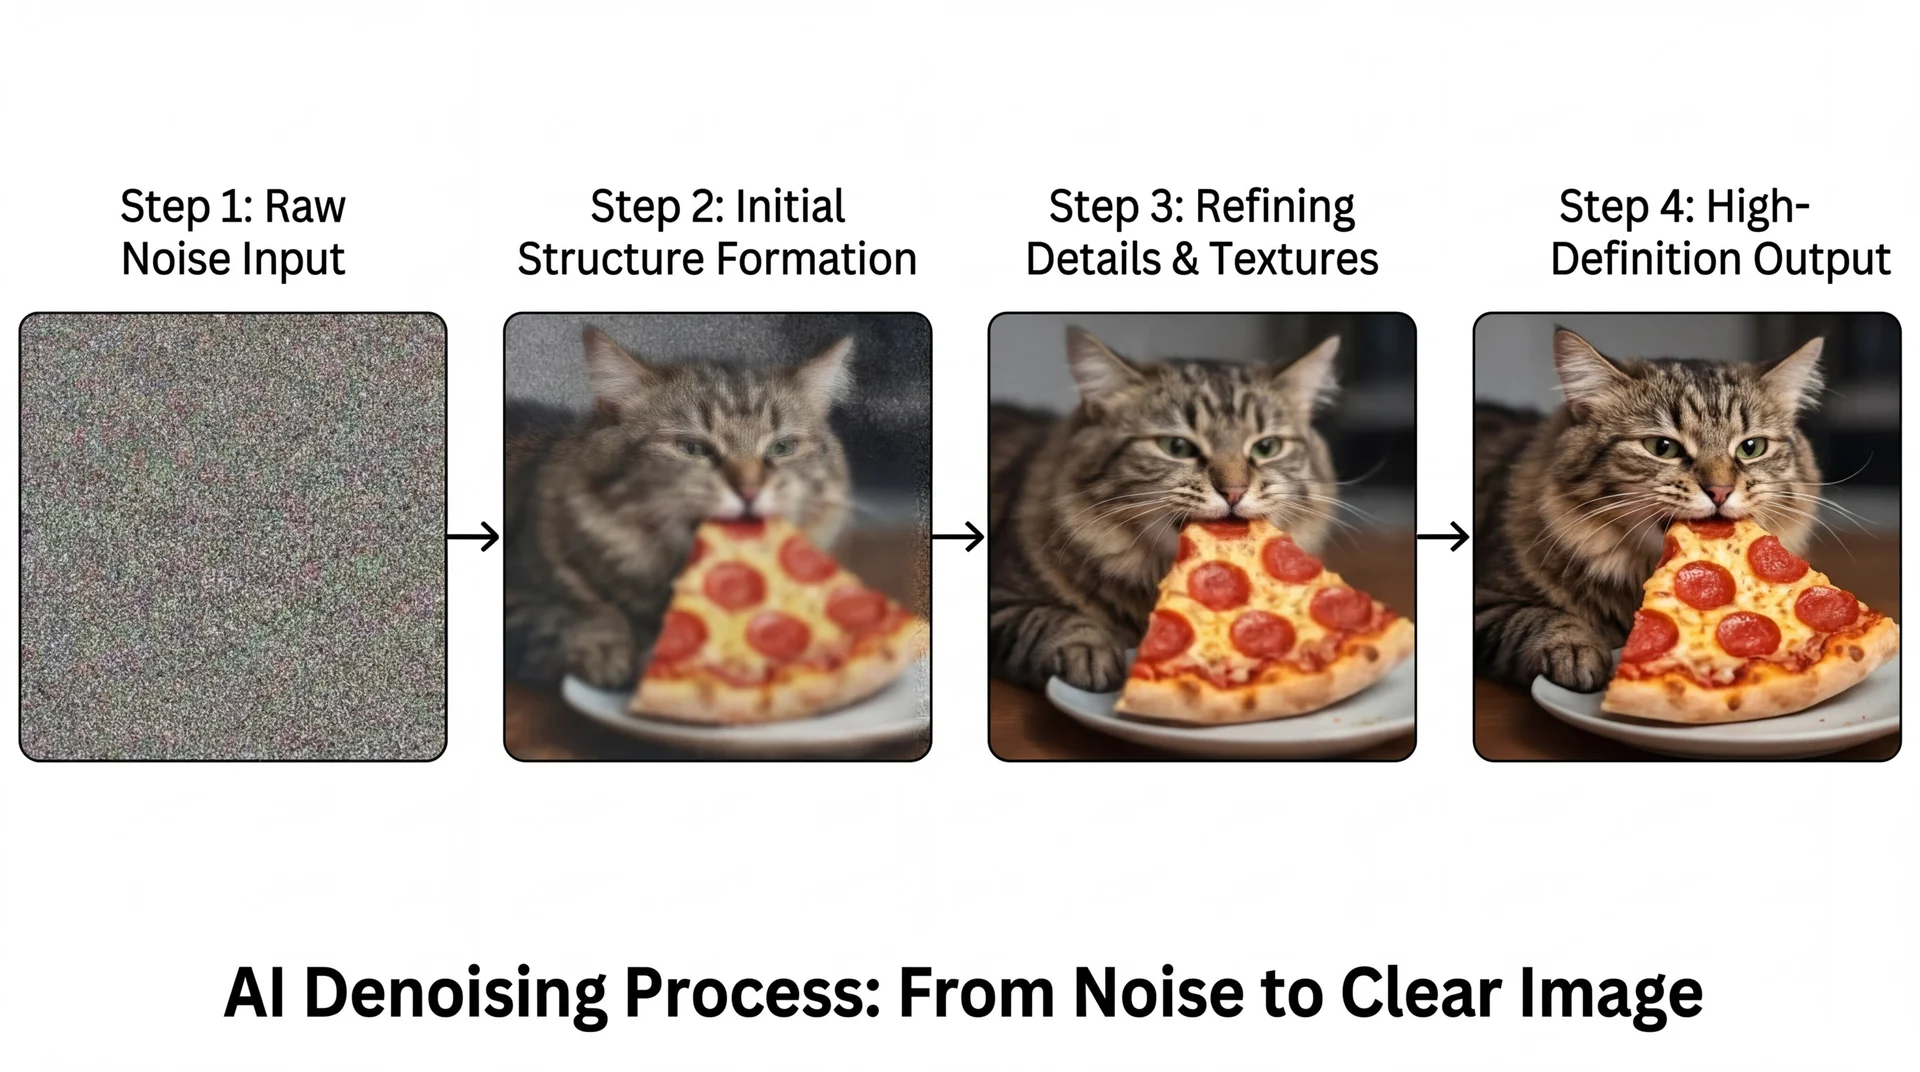
所以它更像雕刻,而不是繪畫。畫家在空白畫布上添加顏料,模型則一點一點鑿去雜訊,直到畫面顯現出來。
AI 如何生成影片
影片更難,因為多了時間。分別生成 24 張貓的圖片,你會得到 24 隻略有不同的貓,連起來播放時畫面會閃爍。影片模型會一次畫好翻頁書的所有頁面:畫某一格時,它會參照前後的畫格,讓毛色保持不變、動作連貫流暢。
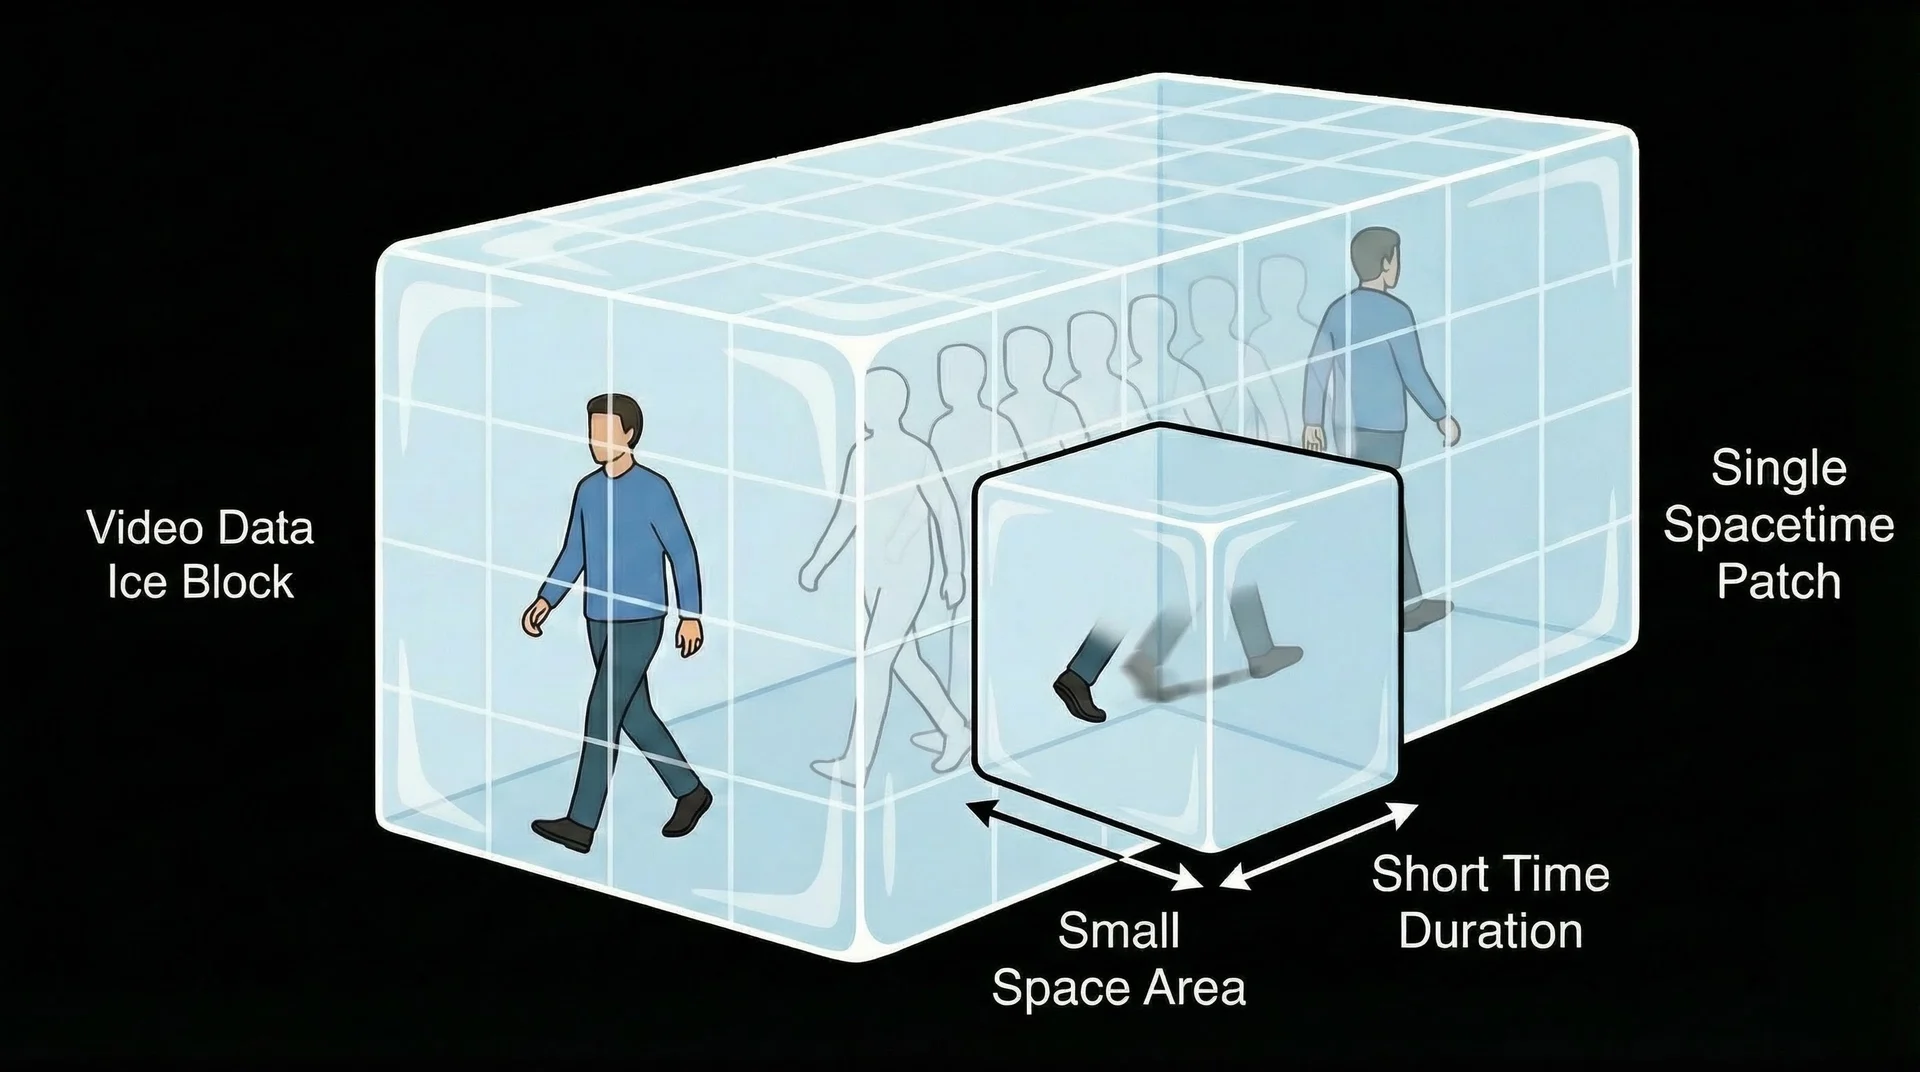
它以一個個叫時空區塊(spacetime patch)的小塊為單位運作。把一段 5 秒的影片想像成一塊冰:正面是第 0 秒,深度就是時間。模型把這塊冰切成成千上萬個小冰塊,每個小冰塊都知道畫面中一小部分長什麼樣子、又是怎麼移動的。把這些會動的小塊拼在一起,角色就不會突然換了衣服或消失不見。
AI 怎麼知道貓長什麼樣子?
它從大量帶標籤的圖片中學習,例如一張標著「貓」的貓咪照片。簡單來說,它不會保存這些照片,而是學會了配方:貓通常有兩隻尖耳朵、鬍鬚和毛。
這對你製作 AI 影片代表什麼
關鍵名詞
- AIGC:AI 生成內容(AI-generated content),指由 AI 模型創作的圖片、影片、音樂或文字。
- 潛在空間(latent space):模型的概念地圖,相似的想法彼此靠得很近。
- 擴散(diffusion):從隨機雜訊開始,一步步去除雜訊,最後得到一張畫面。
- 時空區塊(spacetime patch):影片中的一小塊,既包含畫面的一部分,也包含它在短時間內怎麼移動。
常見問題
AIGC 是什麼的縮寫?
AI-generated content,也就是 AI 生成內容:由 AI 模型創作、而不只是分析的圖片、影片、音樂和文字。
AIGC 和傳統 AI 有什麼不同?
傳統 AI 辨識並標註已經存在的東西,例如手機的臉部解鎖。AIGC 則依照要求創造新東西,例如一張從未存在過的臉部圖片。
AI 圖片生成器是怎麼運作的?
它先在潛在空間(一張概念地圖)裡找到這個想法,再用擴散生成畫面:從隨機雜訊開始,一步步去除雜訊,直到畫面符合提示詞。
為什麼 AI 影片比 AI 圖片更難?
因為影片多了時間。模型必須讓每一格保持一致,所以它用一個個小的時空區塊把整段影片一起生成,而不是一格一格分開畫。
逐字稿
0:00 · 什麼是 AIGC
什麼是 AIGC?AI 生成內容指的是一種人工智慧,它能創造新的內容,而不只是分析現有的資料。傳統 AI 專注於辨識模式,例如用臉部解鎖手機。AIGC 專注於創造,生成一張現實世界中從未存在過的新面孔。
0:23 · 美食評論家與廚師
傳統 AI 就像一位美食評論家。你給它看一道菜,它就會分析:「這是義大利麵,這是漢堡,這是蛋糕。」它辨識並標註已經存在的東西。AIGC 則像一位廚師。你不用給它看食物,而是向它點餐:「我要一份加鳳梨、多加起司的辣味披薩。」然後它走進廚房,從零開始做出一道全新的菜。它不是去冰箱拿一個冷凍披薩給你,而是現做一個從未存在過的新鮮披薩。
0:58 · 第 1 步:在潛在空間裡想像
AI 如何生成圖像第一步是想像。把潛在空間想像成一座由許多角落(概念)組成的巨大圖書館。原理是這樣的:在這座圖書館裡,放的不是書,而是屬性。每個物體的位置取決於它和其他物體有多相似。想像一個巨大的圖書館房間。一個角落是毛茸茸角,一個角落是機械角,還有一個角落是食物角。如果你要一隻貓, AI 會飛到圖書館裡的某個點,也就是毛茸茸、尖耳朵和鬍鬚交會的地方。如果你要一隻機器貓, AI 會找到一個正好位於機械角和毛茸茸角正中間的位置。為什麼這很重要?AI 不是從記憶裡複製一隻貓。它會去到大腦裡貓的座標,根據在那些座標上找到的配方,造出一隻全新的貓。
1:56 · 第 2 步:用擴散來創造
第二步是創造。AI 有了想法之後,需要把它變成畫面。它使用一種叫「擴散」的過程。AI 從一個滿是雜訊雪花的畫面開始,就像沒有訊號的電視。你告訴 AI:「給我看一隻正在吃披薩的貓。」它看著這些雜訊,問自己:「如果我稍微改一改這些點,會不會更像一隻貓?」它把這個過程重複成千上萬次,不斷去噪,直到一張清晰的高畫質圖像出現。它不像人類那樣在空白畫布上添加顏料作畫,而是從混沌中雕刻出秩序。
2:37 · AI 如何生成影片
AI 如何生成影片像 Sora、Runway、Kling 這樣的影片生成要難得多,因為它多了一個新維度:時間。如果你讓 AI 生成 24 張貓的圖片,你會得到 24 隻不同的貓。把它們拼成一段影片時,畫面會閃爍,看起來一團亂。影片 AI 會一次生成一本翻頁書的所有頁面。畫第 2 頁時,它會看第 1 頁,確保貓的毛色沒有變。它也會看第 3 頁,確保動作流暢。它不只是處理像素,也就是那些微小的點,AI 處理的是「區塊」(patch),它們同時代表空間(圖像的一部分)和時間(這一部分在幾秒內如何移動)。它會一次生成整條時間軸,確保故事從頭到尾都合情合理。
3:29 · AI 如何學會貓長什麼樣子
你可能會好奇:它怎麼知道貓長什麼樣子?AI 看過網路上數十億張帶標籤的圖片,例如一張標著「貓」的貓咪照片。它並不會記住照片本身,而是學習事物的數學「配方」。它不會存一張貓的 JPEG 圖檔,而是存下概念:貓通常有兩隻尖耳朵、鬍鬚和毛。
3:56 · 最難的部分:時空區塊
這是最難的部分。要做影片,AI 必須確保動作流暢,並且前後一致,方法是把影片拆成同時包含圖像和時間的 3D 資料塊。想像一段 5 秒的影片是一整塊透明的冰。冰塊的正面是起點,也就是第 0 秒;冰塊的深度就是時間,到最後面是第 5 秒。AI 把這塊巨大的冰切成成千上萬個小冰塊。每個小冰塊,也就是時空區塊(patch),都是一塊會動的拼圖。它清楚知道圖像中一小部分長什麼樣子,以及它在這幾秒內應該怎樣移動。為什麼這樣行得通?把這些會動的小冰塊拼在一起,AI 能確保角色不會突然換了衣服,也不會在移動時消失,因為時間和動作都已經內建在冰塊裡。
4:50 · 回顧:雕塑家與翻頁書畫家
圖像 AI 就像一位雕塑家,一點點鑿去靜態的雜訊,讓畫面顯現出來。影片 AI 就像一位翻頁書畫家,一次畫好所有頁面,讓故事流暢地推進。