第 1 部分 · 第 1 课,共 6 课
什么是 AIGC?AI 如何生成图片和视频
AIGC(AI 生成内容,AI-generated content)是能创造新东西的 AI,比如一张图片、一段视频、一首歌或一段文字,而不只是识别已经存在的东西。图像模型先在一座“概念图书馆”里找到这个想法,再一步步去掉随机噪点,直到出现一张符合描述的画面。视频模型在时间维度上做同样的事,所以整段视频从第一帧到最后一帧都能保持一致。
AIGC 和传统 AI:美食评论家与厨师
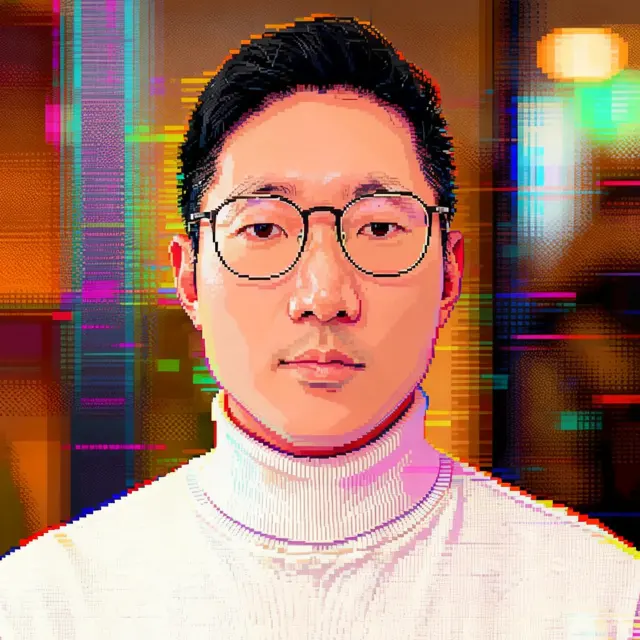
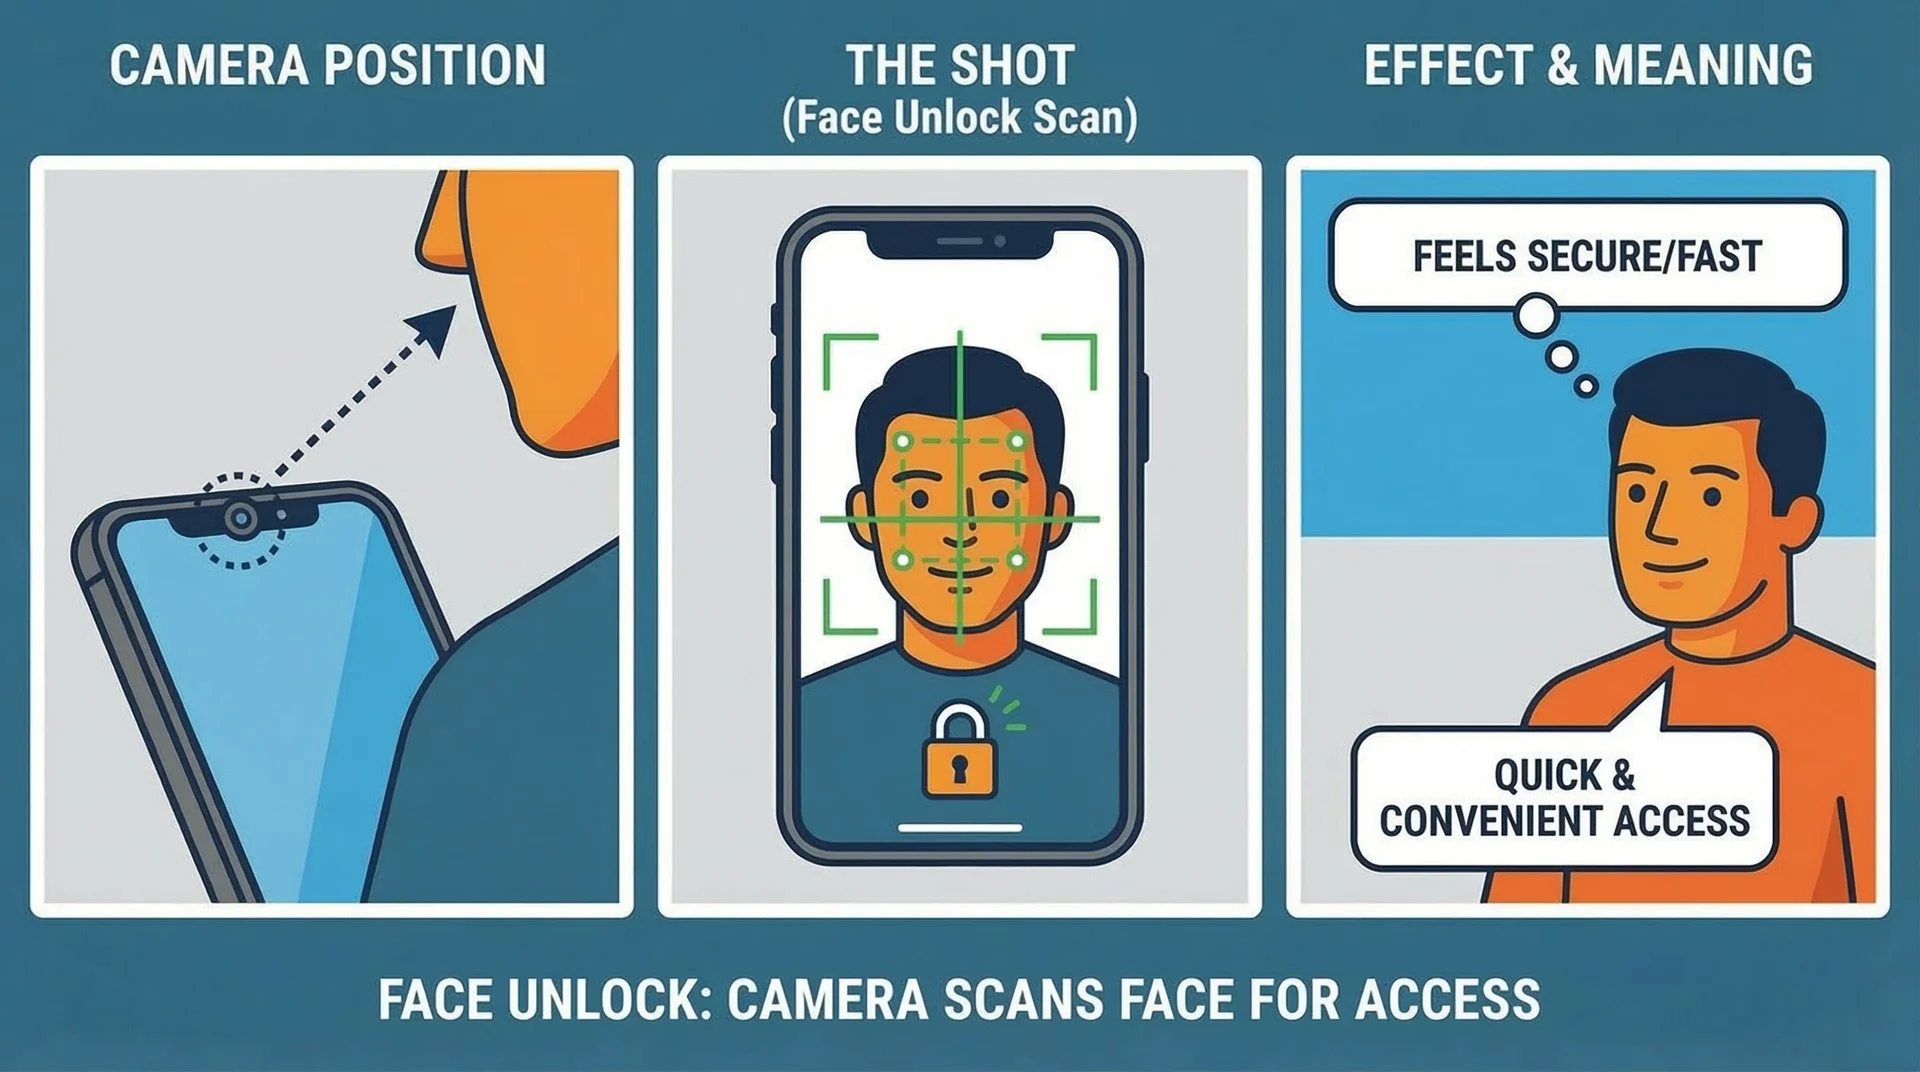
传统 AI 识别已经存在的东西。它就像一位美食评论家:给它看一道菜,它会告诉你“这是意面,这是汉堡,这是蛋糕。”用人脸解锁手机也是同样的原理。
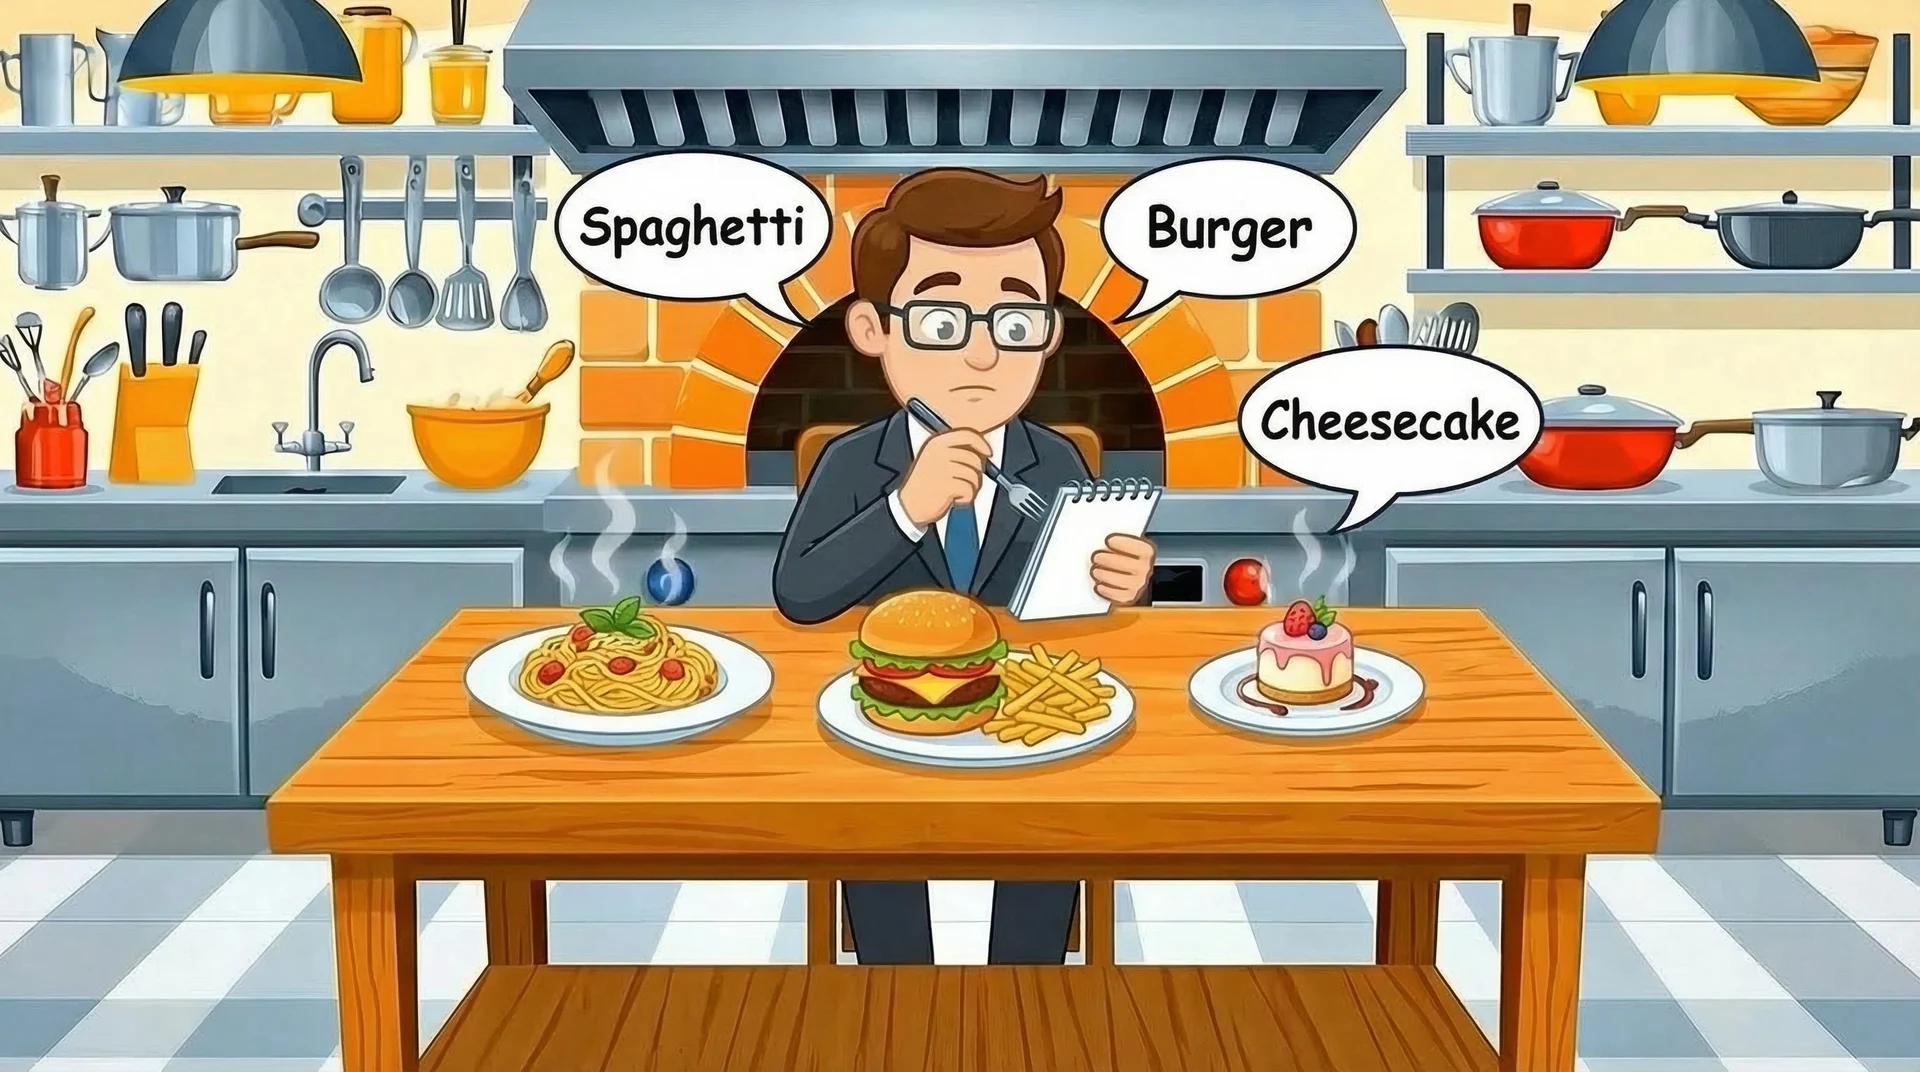
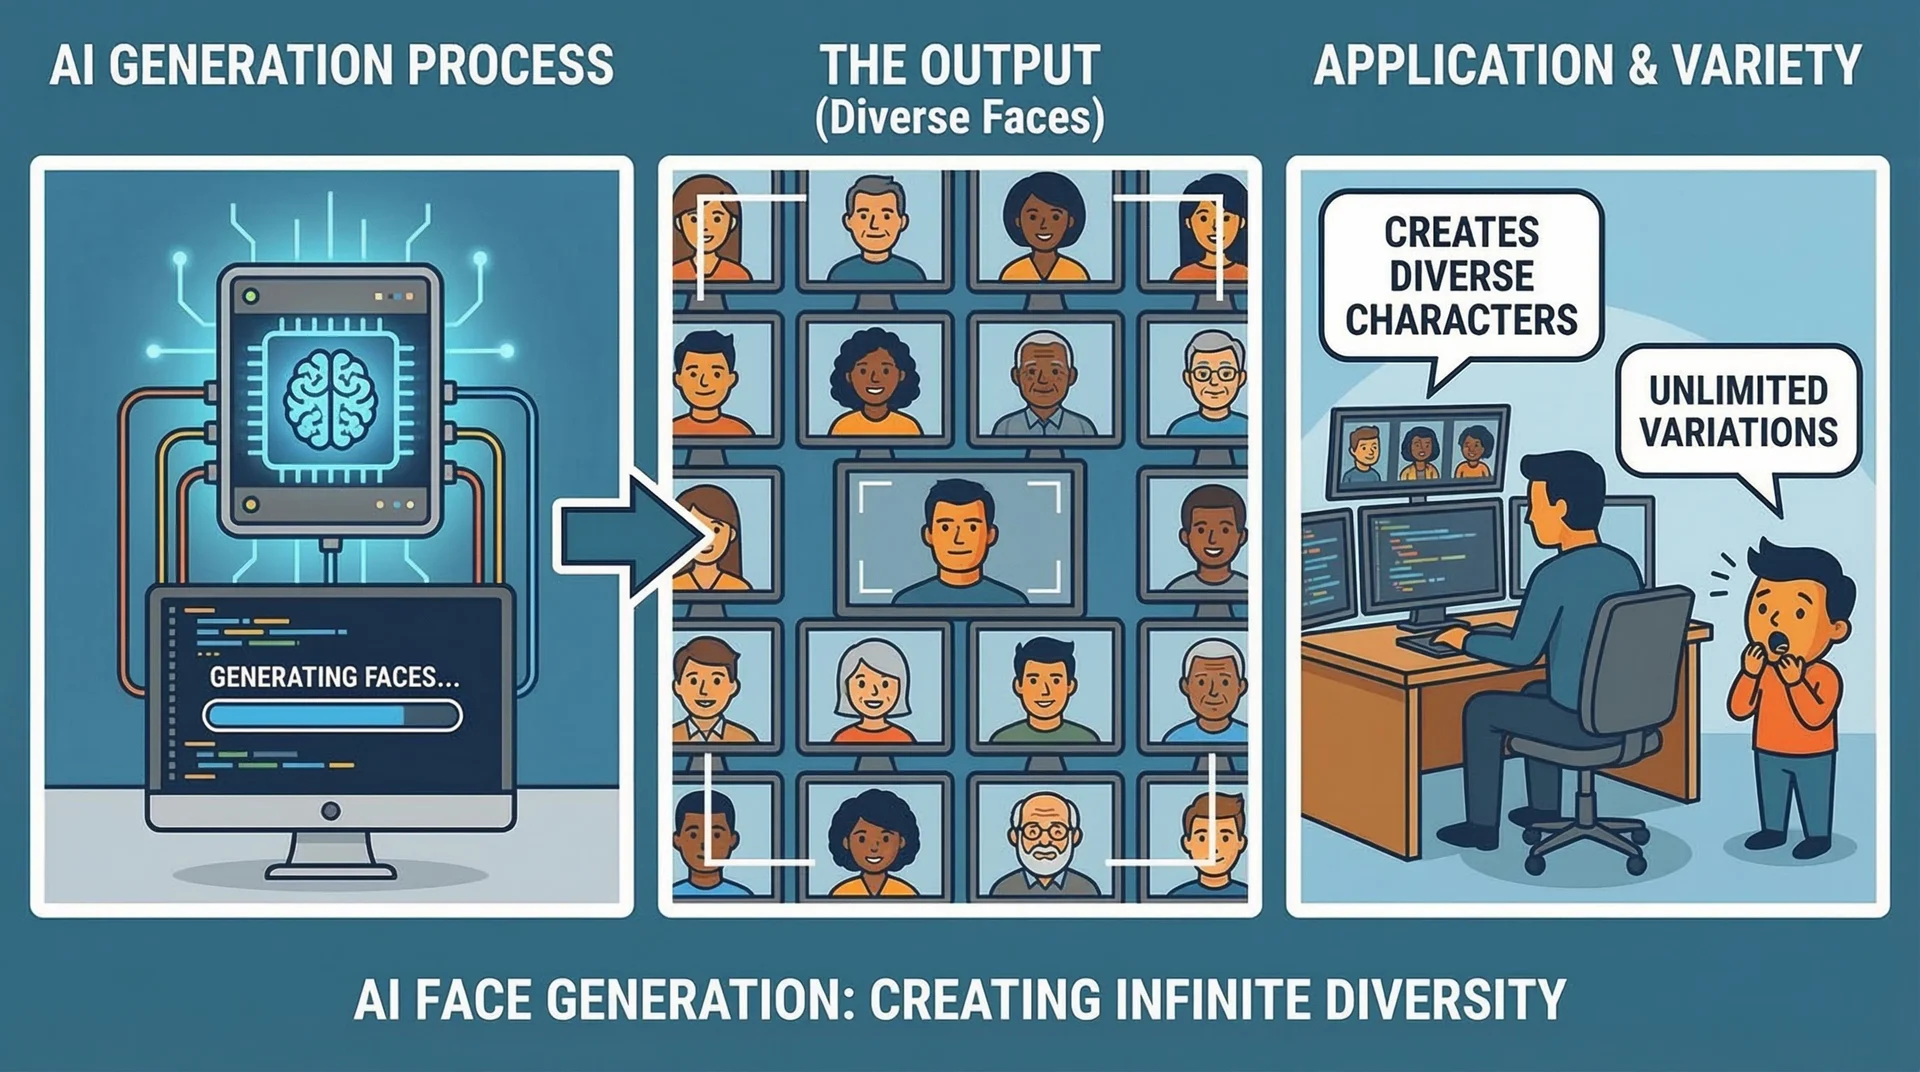
AIGC 则像一位厨师。你不用给它看任何食物,而是给它下单,比如“一份加菠萝、多加芝士的辣味披萨”,它就会从零开始做出一道新菜,而不是从冰箱里拿一个冷冻披萨给你。同样地,它也能画出一张从未存在过的脸。
第 1 步:想象,一座概念图书馆
在动笔之前,模型会先在所谓的潜在空间里找到这个想法。把它想象成一座巨大的图书馆:里面没有书,只有属性,相似的东西彼此挨得很近,比如毛茸茸角、机械角和食物角。
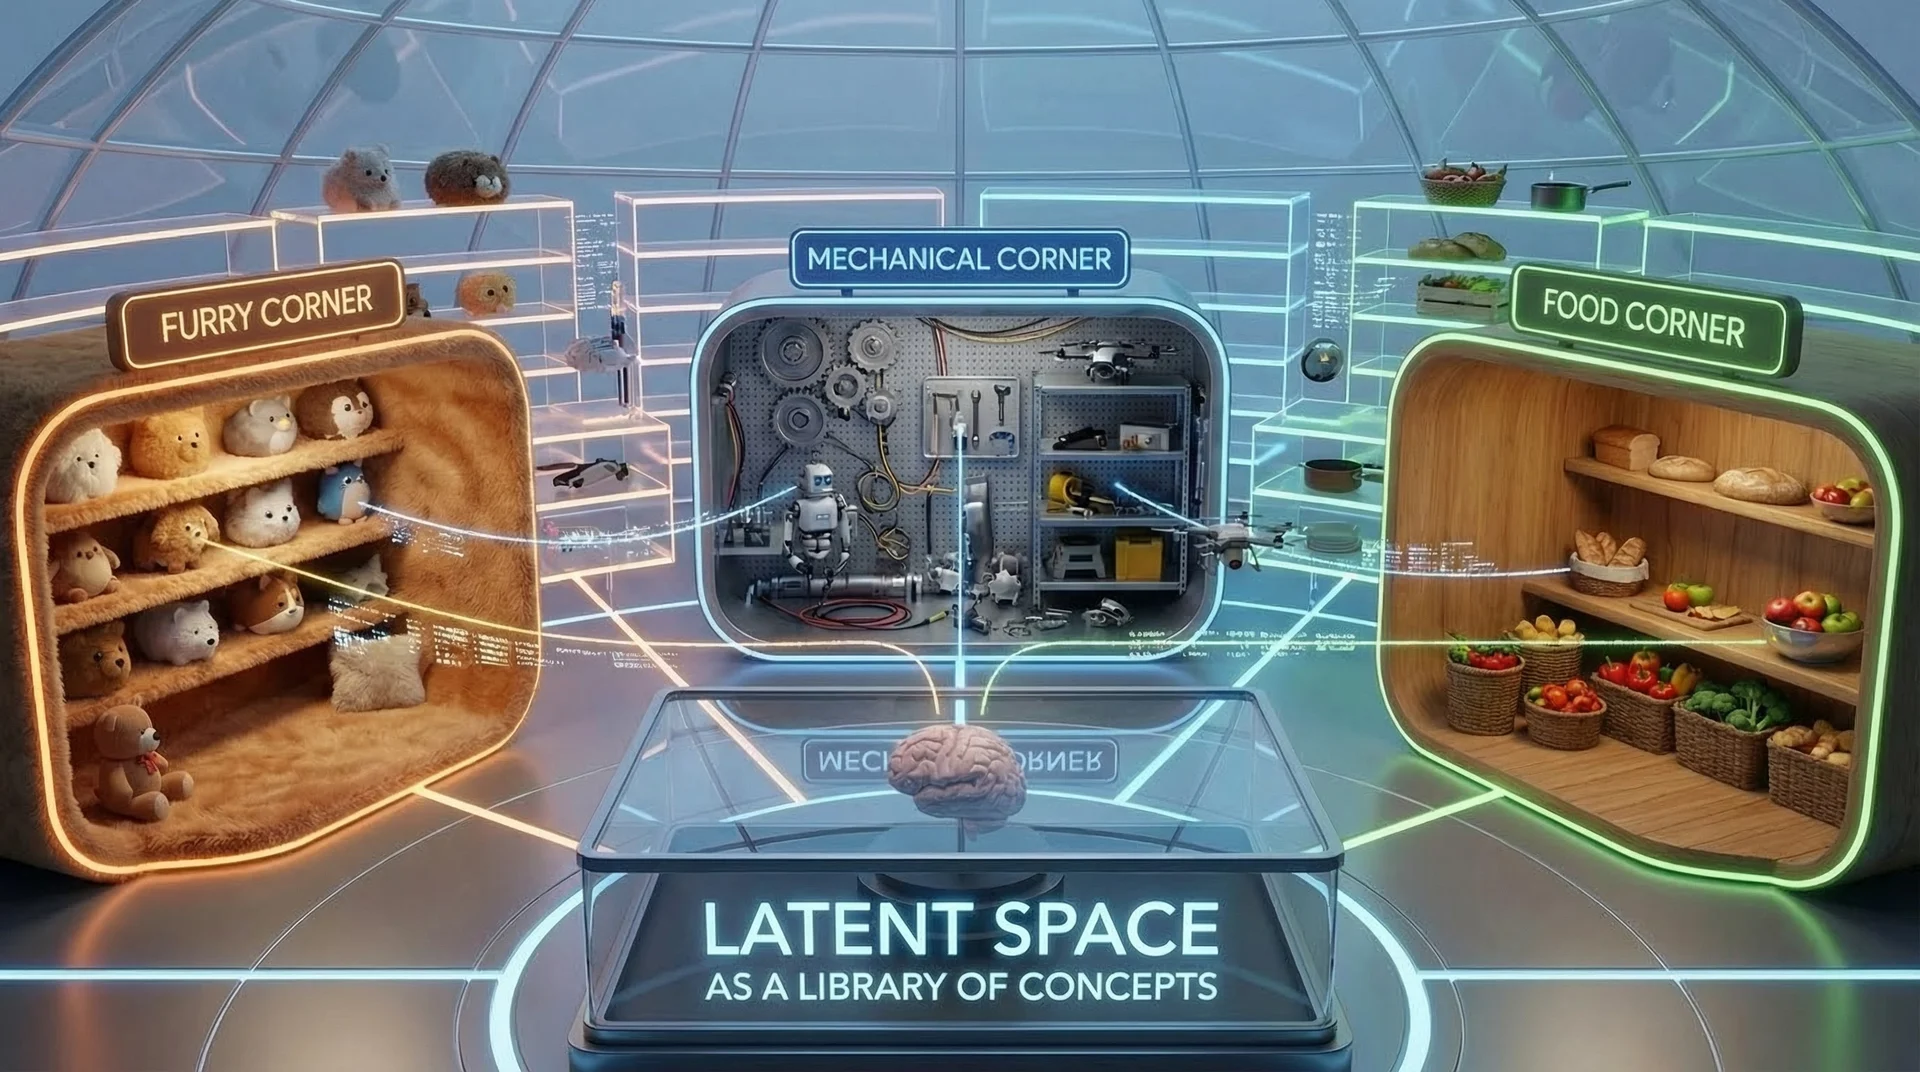
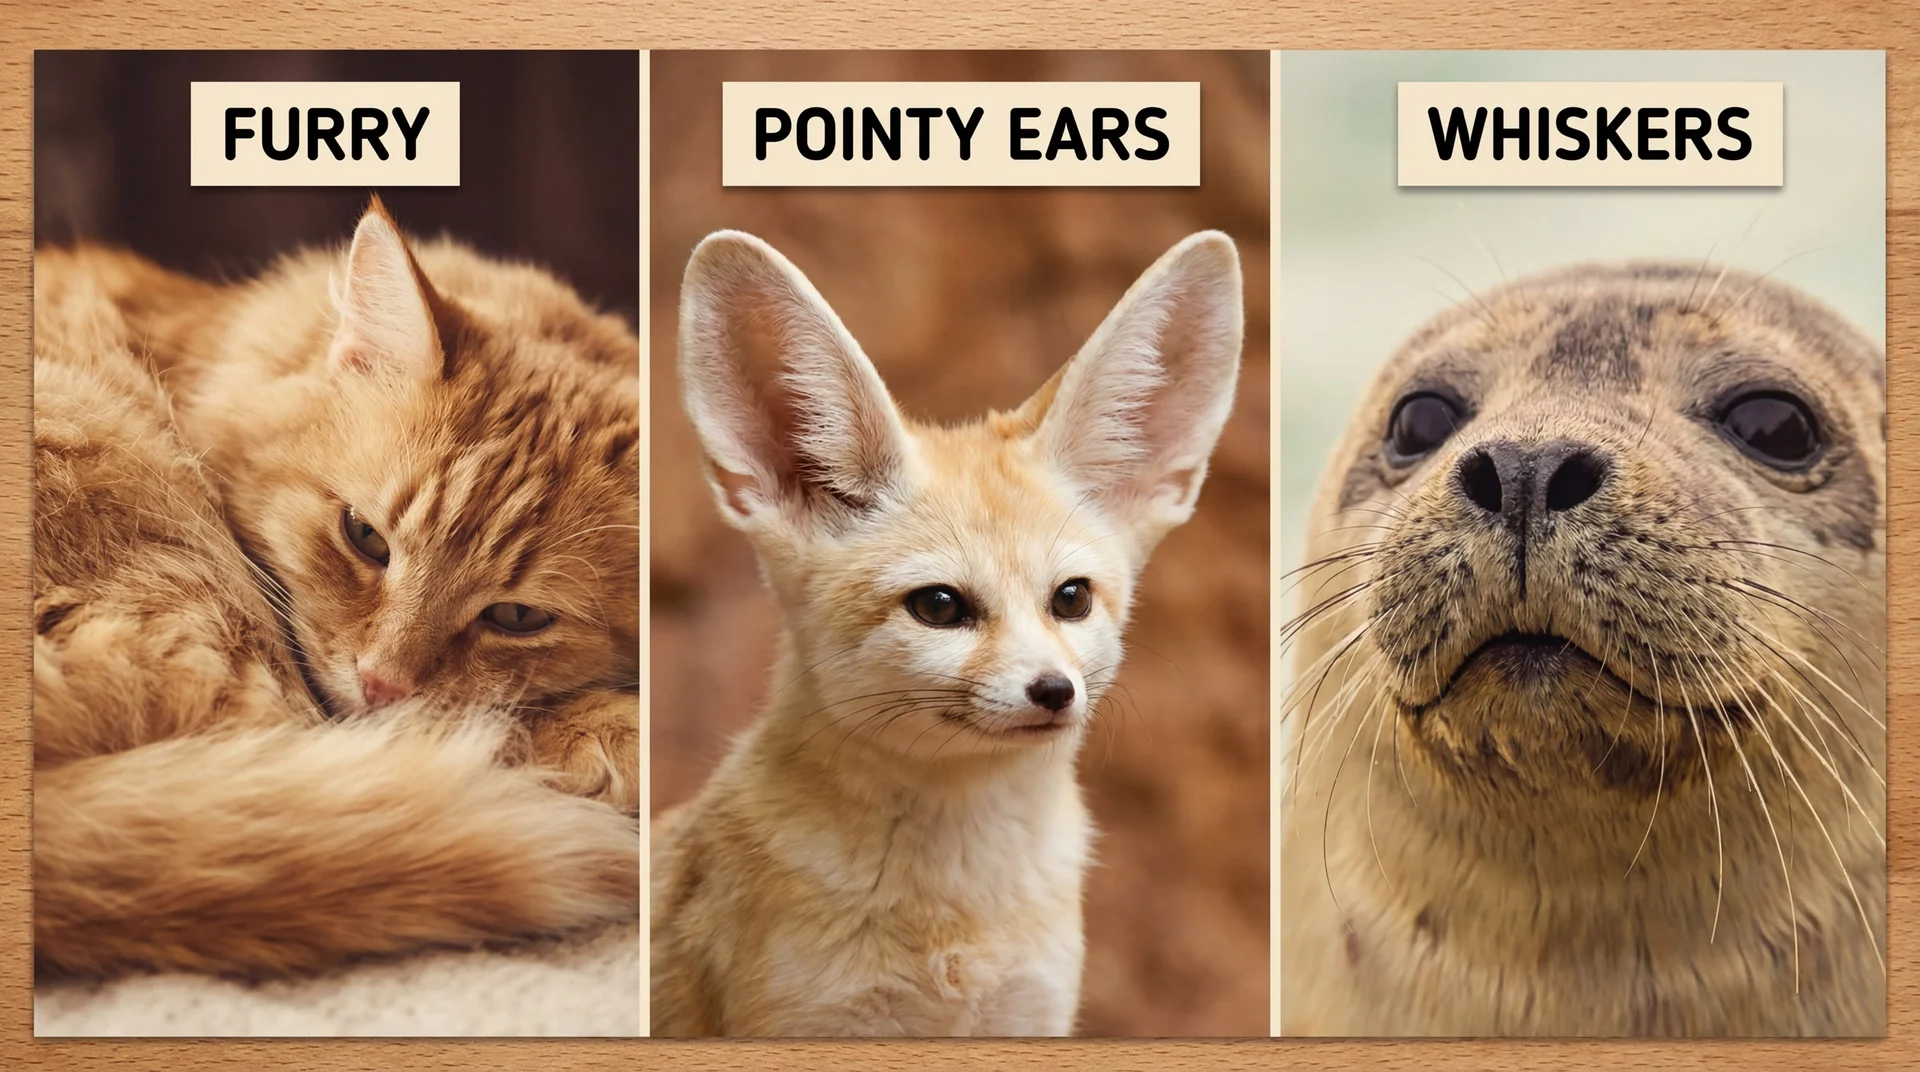
你要一只猫,模型就会去“毛茸茸”“尖耳朵”和“胡须”交汇的地方。你要一只机器猫,它就会去机械角和毛茸茸角正中间的位置。它不是从记忆里复制一只猫,而是按照在那里找到的配方,造出一只全新的猫。
第 2 步:创造,从噪点到画面
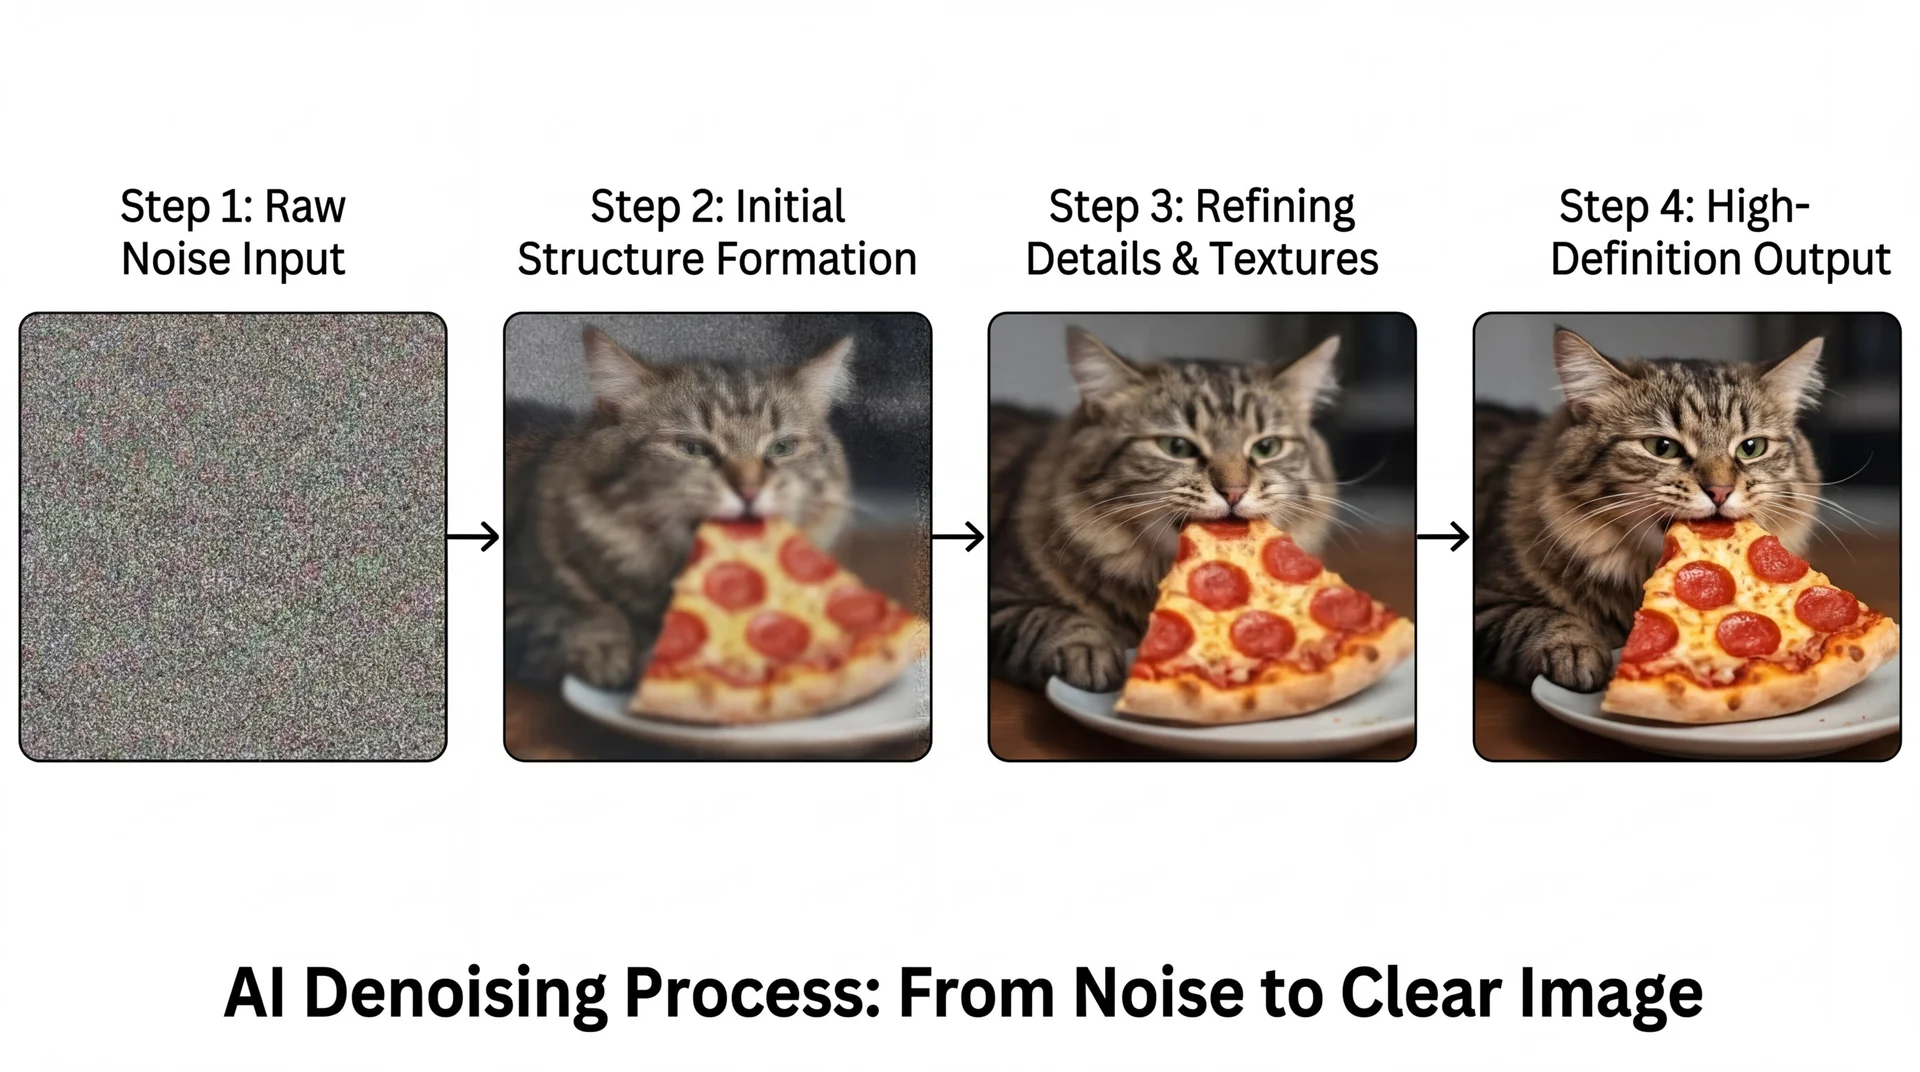
图像模型使用一种叫扩散的过程。它从满屏的随机噪点开始,就像没有信号的电视。拿到“一只正在吃披萨的猫”这样的提示词,模型会问自己:如果我把这些点稍微改一改,会不会更像一只猫?它把这个过程重复很多次,一步步去掉噪点,直到出现一张清晰的画面。
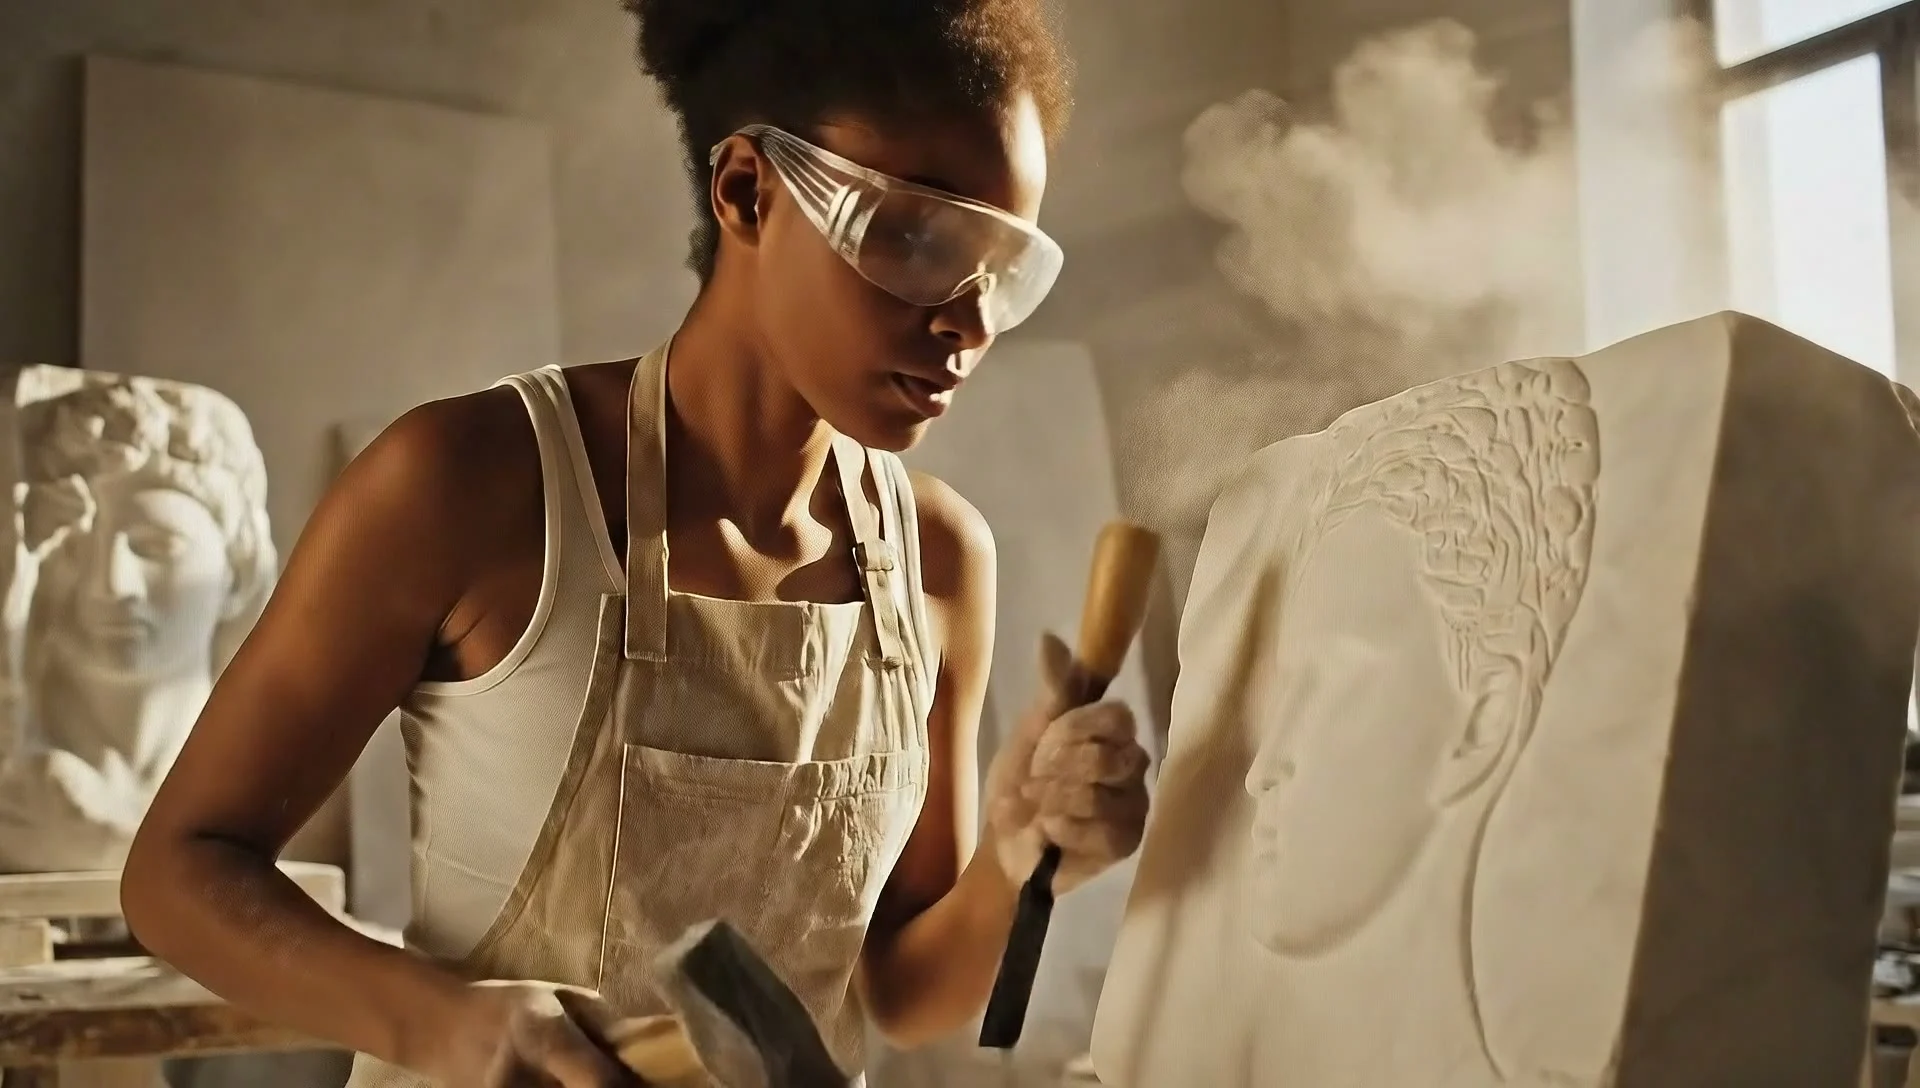
所以它更像雕刻,而不是绘画。画家在空白画布上添加颜料,模型则一点点凿去噪点,直到画面显现出来。
AI 如何生成视频
视频更难,因为多了时间。分别生成 24 张猫的图片,你会得到 24 只略有不同的猫,连起来播放时画面会闪烁。视频模型会一次画好翻页书的所有页面:画某一帧时,它会参照前后的帧,让毛色保持不变、动作连贯流畅。
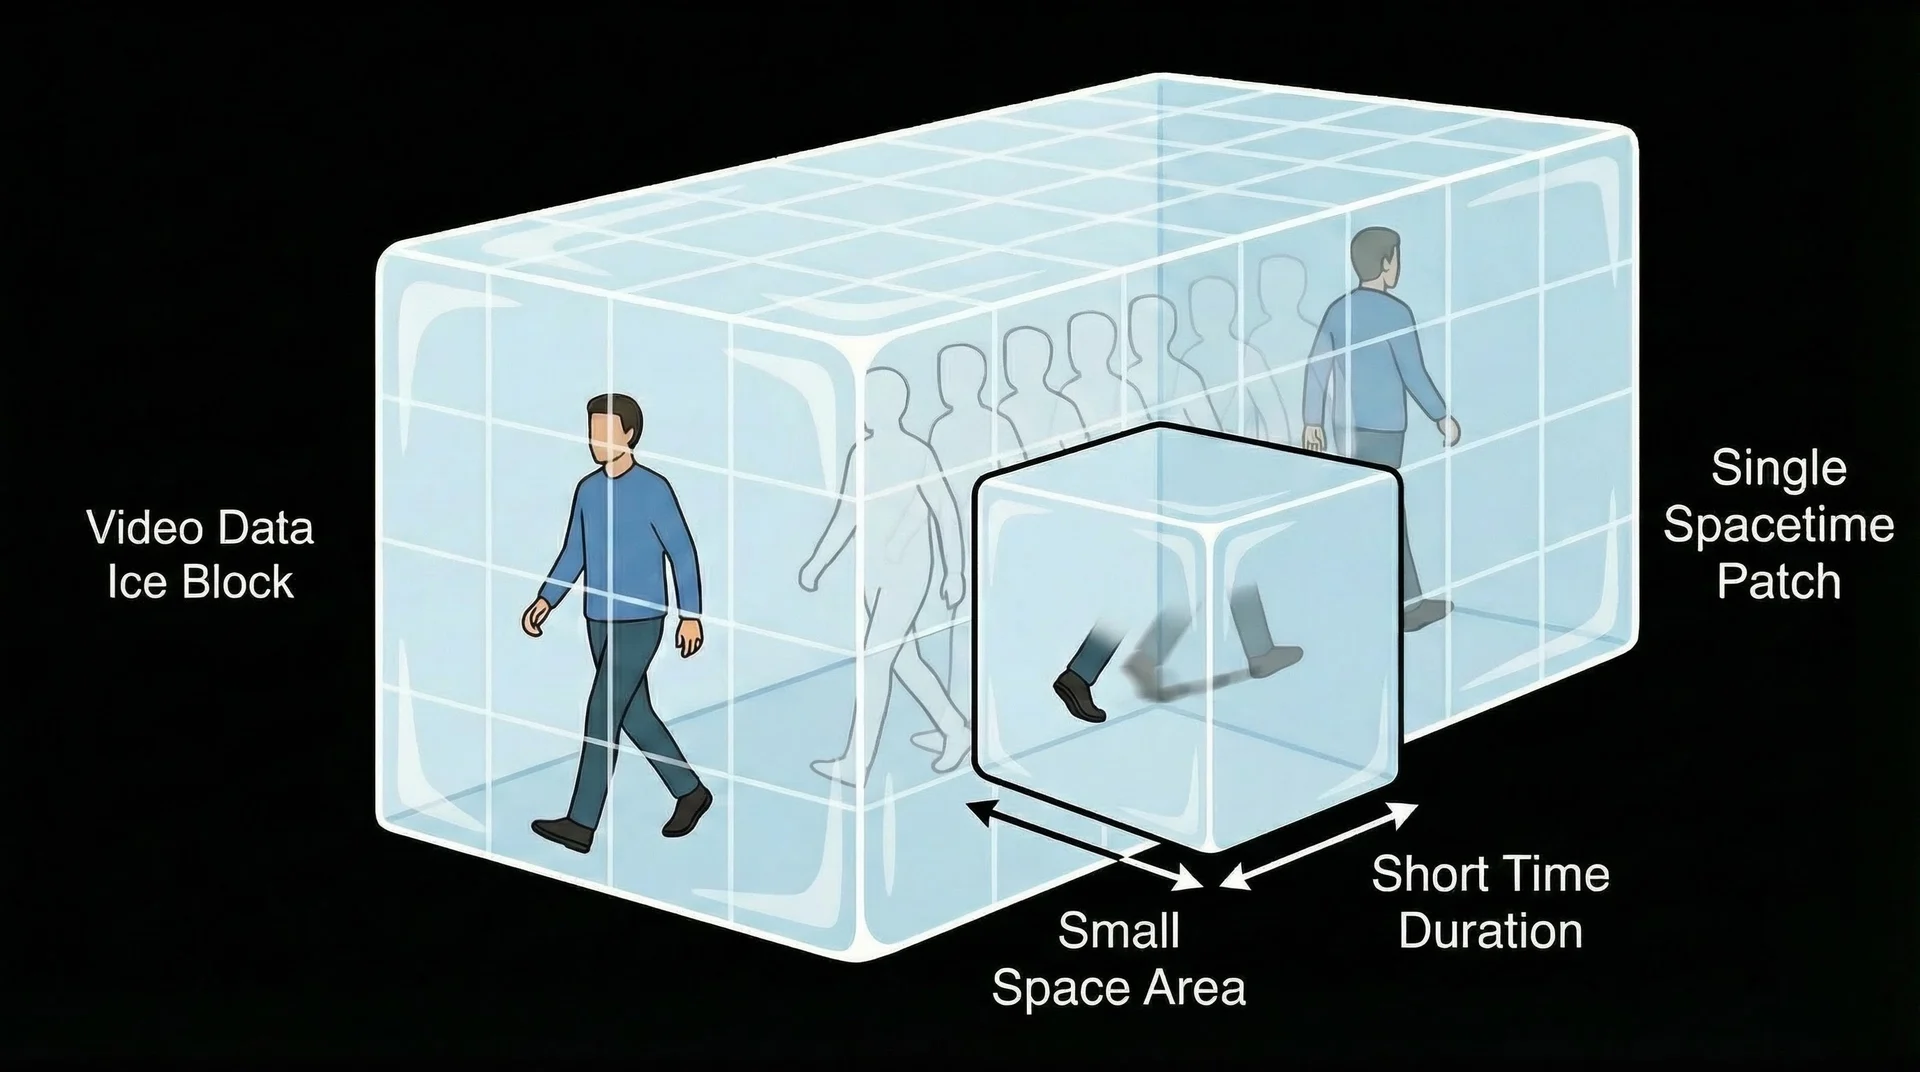
它以一个个叫时空块(spacetime patch)的小块为单位工作。把一段 5 秒的视频想象成一块冰:正面是第 0 秒,深度就是时间。模型把这块冰切成成千上万个小冰块,每个小冰块都知道画面中一小部分长什么样、又是怎样移动的。把这些会动的小块拼在一起,角色就不会突然换了衣服或消失不见。
AI 怎么知道猫长什么样?
它从海量带标签的图片中学习,比如一张标着“猫”的猫咪照片。简单来说,它不会保存这些照片,而是学会了配方:猫通常有两只尖耳朵、胡须和毛。
这对你制作 AI 视频意味着什么
关键术语
- AIGC:AI 生成内容(AI-generated content),指由 AI 模型创作的图片、视频、音乐或文字。
- 潜在空间(latent space):模型的概念地图,相似的想法彼此挨得很近。
- 扩散(diffusion):从随机噪点开始,一步步去掉噪点,最终得到一张画面。
- 时空块(spacetime patch):视频中的一小块,既包含画面的一部分,也包含它在短时间内怎样移动。
常见问题
AIGC 是什么的缩写?
AI-generated content,即 AI 生成内容:由 AI 模型创作、而不只是分析的图片、视频、音乐和文字。
AIGC 和传统 AI 有什么区别?
传统 AI 识别并标注已经存在的东西,比如手机上的人脸解锁。AIGC 则根据要求创造新东西,比如一张从未存在过的人脸图片。
AI 图片生成器是怎么工作的?
它先在潜在空间(一张概念地图)里找到这个想法,再用扩散生成画面:从随机噪点开始,一步步去掉噪点,直到画面符合提示词。
为什么 AI 视频比 AI 图片更难?
因为视频多了时间。模型必须让每一帧保持一致,所以它用一个个小的时空块把整段视频一起生成,而不是逐帧单独绘制。
文字稿
0:00 · 什么是 AIGC
什么是 AIGC?AI 生成内容指的是一种人工智能,它能创造新的内容,而不只是分析现有数据。传统 AI 专注于识别模式,比如用人脸解锁手机。AIGC 专注于创造,生成一张现实世界中从未存在过的新面孔。
0:23 · 美食评论家与厨师
传统 AI 就像一位美食评论家。你给它看一道菜,它就会分析:“这是意面,这是汉堡,这是蛋糕。”它识别并标注已经存在的东西。AIGC 则像一位厨师。你不用给它看食物,而是给它下单:“我要一份加菠萝、多加芝士的辣味披萨。”然后它走进厨房,从零开始做出一道全新的菜。它不是去冰箱拿一个冷冻披萨给你,而是现做一个从未存在过的新鲜披萨。
0:58 · 第 1 步:在潜在空间里想象
AI 如何生成图像第一步是想象。把潜在空间想象成一座由许多角落(概念)组成的巨大图书馆。原理是这样的:在这座图书馆里,放的不是书,而是属性。每个物体的位置取决于它和其他物体有多相似。想象一个巨大的图书馆房间。一个角落是毛茸茸角,一个角落是机械角,还有一个角落是食物角。如果你要一只猫, AI 会飞到图书馆里的某个点,也就是毛茸茸、尖耳朵和胡须交汇的地方。如果你要一只机器猫, AI 会找到一个正好位于机械角和毛茸茸角正中间的位置。为什么这很重要?AI 不是从记忆里复制一只猫。它会去到大脑里猫的坐标,根据在那些坐标上找到的配方,造出一只全新的猫。
1:56 · 第 2 步:用扩散来创造
第二步是创造。AI 有了想法之后,需要把它变成画面。它使用一种叫“扩散”的过程。AI 从一个满是雪花噪点的画面开始,就像没有信号的电视。你告诉 AI: “给我看一只正在吃披萨的猫。”它看着这些噪点,问自己:“如果我稍微改一改这些点,会不会更像一只猫?”它把这个过程重复成千上万次,不断去噪,直到一张清晰的高清图像出现。它不像人类那样在空白画布上添加颜料作画,而是从混沌中雕刻出秩序。
2:37 · AI 如何生成视频
AI 如何生成视频像 Sora、Runway、Kling 这样的视频生成要难得多,因为它多了一个新维度:时间。如果你让 AI 生成 24 张猫的图片,你会得到 24 只不同的猫。把它们拼成一段视频时,画面会闪烁,看起来一团乱。视频 AI 会一次性生成一本翻页书的所有页面。画第 2 页时,它会看第 1 页,确保猫的毛色没有变。它也会看第 3 页,确保动作流畅。它不只是处理像素,也就是那些微小的点,AI 处理的是“块”(patch),它们同时代表空间(图像的一部分)和时间(这一部分在几秒内如何移动)。它会一次性生成整条时间线,确保故事从头到尾都合情合理。
3:29 · AI 如何学会猫长什么样
你可能会好奇:它怎么知道猫长什么样?AI 看过网上数十亿张带标签的图片,比如一张标着“猫”的猫的照片。它并不会记住照片本身,而是学习事物的数学“配方”。它不会存一张猫的 JPEG 图片,而是存下概念:猫通常有两只尖耳朵、胡须和毛。
3:56 · 最难的部分:时空块
这是最难的部分。要做视频,AI 必须确保动作流畅,并且前后一致,方法是把视频拆成同时包含图像和时间的 3D 数据块。想象一段 5 秒的视频是一整块透明的冰。冰块的正面是起点,也就是第 0 秒;冰块的深度就是时间,到最后面是第 5 秒。AI 把这块巨大的冰切成成千上万个小冰块。每个小冰块,也就是时空块(patch),都是一块会动的拼图。它清楚知道图像中一小部分长什么样,以及它在这几秒内应该怎样移动。为什么这样行得通?把这些会动的小冰块拼在一起,AI 能确保角色不会突然换了衣服,也不会在移动时消失,因为时间和动作都已经内建在冰块里。
4:50 · 回顾:雕塑家与翻页书画师
图像 AI 就像一位雕塑家,一点点凿去静态的噪点,让画面显现出来。视频 AI 就像一位翻页书画师,一次画好所有页面,让故事流畅地推进。